
14.10. Свёртка с транспонированием
Слои CNN, которые мы рассматривали до сих пор, такие как свёрточные слои (Section 7.2) и слои пулинга (Section 7.5), как правило, уменьшают (выполняют даунсемплинг) пространственные размерности (высоту и ширину) входа или оставляют их без изменений. В семантической сегментации, где классификация выполняется на уровне пикселей, удобно, чтобы пространственные размерности входа и выхода совпадали. Например, размерность каналов одного выходного пикселя может содержать результаты классификации для входного пикселя в той же пространственной позиции.
Для этого, особенно после того как пространственные размеры были уменьшены слоями CNN, мы можем использовать другой тип слоёв CNN, способный увеличивать (апсемплировать) пространственные размеры промежуточных карт признаков. В этом разделе мы рассмотрим транспонированную свёртку, которую также называют свёрткой с дробным шагом (Dumoulin and Visin, 2016), для выполнения операций, обратных уменьшению размера при свёртке.
import torch
from torch import nn
from d2l import torch as d2l
14.10.1. Базовые операции
Игнорируя пока каналы, рассмотрим базовую операцию транспонированной свёртки с шагом 1 и без дополнения. Предположим, что нам заданы входной тензор \(n_h \times n_w\) и ядро \(k_h \times k_w\). Скольжение окна ядра с шагом 1 \(n_w\) раз по каждой строке и \(n_h\) раз по каждому столбцу даёт в общей сложности \(n_h n_w\) промежуточных результата. Каждый промежуточный результат — это тензор \((n_h + k_h - 1) \times (n_w + k_w - 1)\), инициализированный нулями. Для вычисления каждого промежуточного тензора каждый элемент входного тензора умножается на ядро, так что результирующий тензор \(k_h \times k_w\) заменяет соответствующую часть в каждом промежуточном тензоре. Обратите внимание, что позиция заменяемой части в каждом промежуточном тензоре соответствует позиции элемента во входном тензоре, использованного для вычисления. В конце все промежуточные результаты суммируются для получения выходного тензора.
В качестве примера Fig. 14.10.1 показано, как вычисляется транспонированная свёртка с ядром \(2\times 2\) для входного тензора \(2\times 2\).
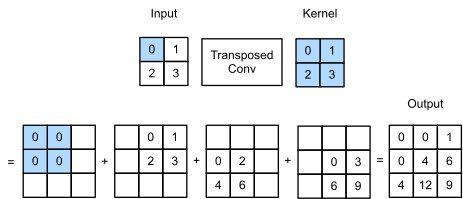
Fig. 14.10.1 Транспонированная свёртка с ядром \(2\times 2\). Заштрихованные области показывают часть промежуточного тензора, а также элементы входного и ядрового тензоров, используемые для вычисления.
Мы можем реализовать эту базовую операцию транспонированной свёртки
trans_conv для входной матрицы X и матрицы ядра K.
def trans_conv(X, K):
    h, w = K.shape
    Y = torch.zeros((X.shape[0] + h - 1, X.shape[1] + w - 1))
    for i in range(X.shape[0]):
        for j in range(X.shape[1]):
            Y[i: i + h, j: j + w] += X[i, j] * K
    return Y
В отличие от обычной свёртки (в Section 7.2), которая
уменьшает количество элементов входа с помощью ядра, транспонированная
свёртка расширяет элементы входа с помощью ядра, в результате чего
выходной тензор оказывается больше входного. Мы можем создать входной
тензор X и тензор ядра K из Fig. 14.10.1, чтобы
проверить корректность выходных данных вышеописанной реализации базовой
двумерной операции транспонированной свёртки.
X = torch.tensor([[0.0, 1.0], [2.0, 3.0]])
K = torch.tensor([[0.0, 1.0], [2.0, 3.0]])
trans_conv(X, K)
В качестве альтернативы, если входные данные X и ядро K являются
четырёхмерными тензорами, мы можем использовать высокоуровневые API для
получения тех же результатов.
X, K = X.reshape(1, 1, 2, 2), K.reshape(1, 1, 2, 2)
tconv = nn.ConvTranspose2d(1, 1, kernel_size=2, bias=False)
tconv.weight.data = K
tconv(X)
14.10.2. Дополнение, шаги и несколько каналов
В отличие от обычной свёртки, где дополнение применяется к входным данным, в транспонированной свёртке оно применяется к выходным. Например, если указать количество элементов дополнения по 1 с каждой стороны высоты и ширины, то из результата транспонированной свёртки будут удалены первая и последняя строки и столбцы.
tconv = nn.ConvTranspose2d(1, 1, kernel_size=2, padding=1, bias=False)
tconv.weight.data = K
tconv(X)
В транспонированной свёртке шаги задаются для промежуточных результатов (то есть для выхода), а не для входа. При использовании тех же тензоров входа и ядра, что и в Fig. 14.10.1, увеличение шага с 1 до 2 приводит к увеличению высоты и ширины промежуточных тензоров, а следовательно, и выходного тензора в Fig. 14.10.2.
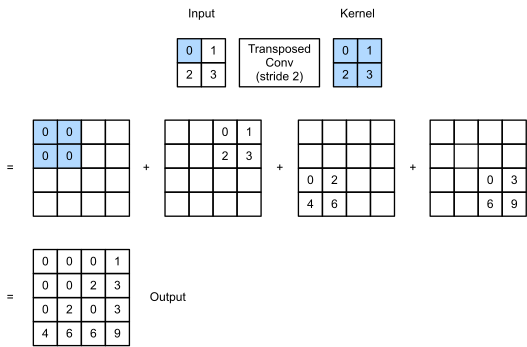
Fig. 14.10.2 Транспонированная свёртка с ядром \(2\times 2\) и шагом 2. Заштрихованные области показывают часть промежуточного тензора, а также элементы входного и ядерного тензоров, используемые для вычислений.
Приведённый ниже фрагмент кода позволяет проверить результат транспонированной свёртки с шагом 2 в Fig. 14.10.2.
tconv = nn.ConvTranspose2d(1, 1, kernel_size=2, stride=2, bias=False)
tconv.weight.data = K
tconv(X)
Для случая нескольких входных и выходных каналов транспонированная свёртка работает так же, как и обычная свёртка. Предположим, что входной тензор имеет \(c_i\) каналов, и транспонированная свёртка сопоставляет каждому входному каналу тензор ядра \(k_h\times k_w\). Когда задано несколько выходных каналов, для каждого выходного канала мы будем иметь тензор ядра \(c_i\times k_h\times k_w\).
Как и в случае со всеми остальными, если мы подаём \(\mathsf{X}\) на вход свёрточного слоя \(f\), чтобы получить на выходе \(\mathsf{Y}=f(\mathsf{X})\), и создаём транспонированный свёрточный слой \(g\) с теми же гиперпараметрами, что и у \(f\), за исключением числа выходных каналов, которое равно числу каналов в \(\mathsf{X}\), то \(g(Y)\) будет иметь ту же форму, что и \(\mathsf{X}\). Это можно проиллюстрировать в следующем примере.
X = torch.rand(size=(1, 10, 16, 16))
conv = nn.Conv2d(10, 20, kernel_size=5, padding=2, stride=3)
tconv = nn.ConvTranspose2d(20, 10, kernel_size=5, padding=2, stride=3)
tconv(conv(X)).shape == X.shape
14.10.3. Связь с транспонированием матриц
Транспонированная свёртка названа так в честь транспонирования матрицы.
Чтобы объяснить это, сначала посмотрим, как реализовать свёртки с
помощью матричных умножений. В примере ниже мы определяем входные данные
\(3\times 3\) X и ядро свёртки \(2\times 2\) K, а затем
используем функцию corr2d для вычисления результата свёртки Y.
X = torch.arange(9.0).reshape(3, 3)
K = torch.tensor([[1.0, 2.0], [3.0, 4.0]])
Y = d2l.corr2d(X, K)
Y
Далее мы преобразуем свёрточное ядро K в разреженную матрицу весов
W, содержащую много нулей. Форма матрицы весов равна (\(4\),
\(9\)), а ненулевые элементы взяты из свёрточного ядра K.
def kernel2matrix(K):
    k, W = torch.zeros(5), torch.zeros((4, 9))
    k[:2], k[3:5] = K[0, :], K[1, :]
    W[0, :5], W[1, 1:6], W[2, 3:8], W[3, 4:] = k, k, k, k
    return W

W = kernel2matrix(K)
W
Склеим входные данные X построчно, чтобы получить вектор длины 9.
Затем матричное умножение матрицы W на векторизованный вектор X
даст вектор длины 4. После изменения формы мы получим тот же результат
Y, что и при выполнении исходной операции свёртки: таким образом, мы
реализовали свёртки с помощью матричного умножения.
Y == torch.matmul(W, X.reshape(-1)).reshape(2, 2)
Аналогичным образом мы можем реализовать транспонированные свёртки с
помощью умножения матриц. В следующем примере мы возьмём выход
\(2 \times 2\) Y из приведённой выше обычной свёртки в качестве
входа для транспонированной свёртки. Чтобы реализовать эту операцию с
помощью умножения матриц, нам нужно лишь транспонировать матрицу весов
W, изменив её форму на новую \((9, 4)\).
Z = trans_conv(Y, K)
Z == torch.matmul(W.T, Y.reshape(-1)).reshape(3, 3)
Рассмотрим реализацию свёртки через умножение матриц. Пусть задан входной вектор \(\mathbf{x}\) и матрица весов \(\mathbf{W}\). Функция прямого распространения свёртки реализуется умножением входных данных на матрицу весов с выдачей вектора \(\mathbf{y}=\mathbf{W}\mathbf{x}\). Поскольку обратное распространение ошибки следует цепному правилу и \(\nabla_{\mathbf{x}}\mathbf{y}=\mathbf{W}^\top\), функция обратного распространения ошибки свёртки реализуется умножением входных данных на транспонированную матрицу весов \(\mathbf{W}^\top\). Таким образом, слой транспонированной свёртки может просто поменять местами функции прямого и обратного распространения ошибки свёрточного слоя: его функции прямого и обратного распространения ошибки умножают входной вектор на \(\mathbf{W}^\top\) и \(\mathbf{W}\) соответственно.
14.10.4. Резюме
В отличие от обычной свёртки, которая уменьшает количество входных элементов с помощью ядра, транспонированная свёртка расширяет входные элементы с помощью ядра, в результате чего выходной размер оказывается больше входного.
Если подать \(\mathsf{X}\) в свёрточный слой \(f\) для получения выхода \(\mathsf{Y}=f(\mathsf{X})\) и создать транспонированный свёрточный слой \(g\) с теми же гиперпараметрами, что и у \(f\), за исключением того, что число выходных каналов равно числу каналов в \(\mathsf{X}\), то \(g(Y)\) будет иметь ту же форму, что и \(\mathsf{X}\).
Мы можем реализовать свёртки с помощью умножения матриц. Транспонированный свёрточный слой может просто поменять местами функции прямого распространения и обратного распространения ошибки свёрточного слоя.
14.10.5. Упражнения
В Section 14.10.3 входные данные свёртки
Xи выходные данные транспонированной свёрткиZимеют одинаковую форму. Имеют ли они одинаковые значения? Почему?Эффективно ли использовать умножение матриц для реализации свёрток? Почему?