
20.1. Генеративно-состязательные сети
На протяжении большей части этой книги мы говорили о том, как делать прогнозы. В той или иной форме мы использовали глубокие нейронные сети для изучения отображений от примеров данных к меткам. Такой вид обучения называется дискриминативным обучением, поскольку мы хотим уметь различать фотографии кошек и фотографии собак. Классификаторы и регрессоры являются примерами дискриминативного обучения. Нейронные сети, обученные с помощью обратного распространения ошибки, перевернули всё, что мы думали, что знаем о дискриминативном обучении на больших сложных наборах данных. Точность классификации на изображениях высокого разрешения выросла от бесполезной до уровня человека (с некоторыми оговорками) всего за 5–6 лет. Мы не будем ещё раз расписывать все остальные дискриминативные задачи, в которых глубокие нейронные сети демонстрируют поразительные результаты.
Но машинное обучение — это не только решение дискриминативных задач. Например, имея большой набор данных без каких-либо меток, мы можем захотеть обучить модель, которая компактно описывает характеристики этих данных. Используя такую модель, мы сможем генерировать синтетические примеры, распределённые так же, как и обучающие данные. Например, имея большой корпус фотографий лиц, мы можем захотеть создавать новые фотореалистичные изображения, которые выглядят так, будто они могли быть взяты из того же набора данных. Такой подход называется генеративным моделированием.
До недавнего времени у нас не было методов, способных синтезировать новые фотореалистичные изображения. Однако успех глубоких нейронных сетей в задачах дискриминативного обучения открыл новые возможности. Одним из главных трендов последних трёх лет стало применение дискриминативных нейронных сетей для решения проблем, которые мы обычно не рассматриваем как задачи обучения с учителем. ⟦example⟧ Языковые модели на основе рекуррентных нейронных сетей являются примером использования дискриминативной сети (обученной предсказывать следующий символ), которая после обучения может действовать как генеративная модель.
В 2014 году в прорывной статье были представлены генеративно-состязательные сети (GAN) (Goodfellow et al., 2014) — новый изощренный способ использования мощности дискриминативных моделей для создания качественных генеративных моделей. В основе GAN лежит идея о том, что генератор данных хорош, если мы не можем отличить синтетические данные от реальных. В статистике это называется двухвыборочным тестом — проверкой, позволяющей ответить на вопрос, были ли наборы данных \(X=\{x_1,\ldots, x_n\}\) и \(X'=\{x'_1,\ldots, x'_n\}\) сгенерированы из одного распределения. Главное отличие большинства статистических работ от GAN заключается в том, что последние используют эту идею конструктивным образом. Иными словами, вместо того чтобы просто обучать модель утверждать: «Эй, эти два набора данных не похожи на то, что они происходят из одного распределения», они используют двухвыборочный тест для предоставления сигналов обучения генеративной модели. Это позволяет нам улучшать генератор данных до тех пор, пока он не начнет генерировать данные, похожие на реальные. По крайней мере, он должен обмануть классификатор, даже если наш классификатор представляет собой современную глубокую нейронную сеть.
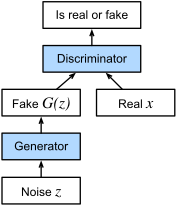
Fig. 20.1.1 Генеративно-состязательные сети
Архитектура GAN показана на рисунке Fig. 20.1.1. Как видно, она состоит из двух частей. Во-первых, нам нужен механизм (например, глубокая нейронная сеть, но это может быть что угодно, такой как игровой движок рендеринга), который потенциально способен генерировать данные, неотличимые от настоящих. Если мы работаем с изображениями, он должен генерировать изображения. Если мы работаем со речью, он должен генерировать аудиосеквенции, и так далее. Мы называем эту сеть генератором. Второй компонент — это дискриминатор. Он пытается отличить поддельные данные от настоящих. Обе сети соревнуются друг с другом. Генератор пытается обмануть дискриминатор. В свою очередь, дискриминатор адаптируется к новым поддельным данным. Эта информация, в свою очередь, используется для улучшения генератора, и так далее.
Дискриминатор — это бинарный классификатор, который определяет, является ли вход \(x\) реальным (из реальных данных) или поддельным (сгенерированным генератором). Как правило, дискриминатор выдает скалярное предсказание \(o\in\mathbb R\) для входа \(\mathbf x\), например, с помощью полносвязного слоя с размером скрытого слоя 1, а затем применяет сигмоидную функцию для получения предсказанной вероятности \(D(\mathbf x) = 1/(1+e^{-o})\). Пусть метка \(y\) для истинных данных равна \(1\), а для поддельных — \(0\). Мы обучаем дискриминатор минимизировать потери перекрёстной энтропии, то есть
Сначала генератор выбирает некоторый параметр \(\mathbf z\in\mathbb R^d\) из источника случайности, например, из нормального распределения \(\mathbf z \sim \mathcal{N} (0, 1)\). Мы часто называем \(\mathbf z\) скрытой переменной. Затем он применяет функцию для генерации \(\mathbf x'=G(\mathbf z)\). Цель генератора — обмануть дискриминатор, чтобы тот классифицировал \(\mathbf x'=G(\mathbf z)\) как настоящие данные, то есть мы хотим, чтобы \(D( G(\mathbf z)) \approx 1\). Иными словами, для заданного дискриминатора \(D\) мы обновляем параметры генератора \(G\), чтобы максимизировать функцию перекрёстной энтропии при \(y=0\), то есть
Если генератор работает идеально, то \(D(\mathbf x')\approx 1\), поэтому приведённая выше функция потерь близка к нулю, что приводит к слишком малым градиентам, не позволяющим дискриминатору эффективно обучаться. Поэтому обычно минимизируют следующую функцию потерь:
что эквивалентно подаче \(\mathbf x'=G(\mathbf z)\) на вход дискриминатора, но с меткой \(y=1\).
Подводя итог, \(D\) и \(G\) участвуют в «минимаксной» игре с общей целевой функцией:
Многие приложения GAN связаны с изображениями. В качестве демонстрации мы сначала ограничимся аппроксимацией гораздо более простого распределения. Мы проиллюстрируем, что произойдет, если использовать GAN для построения самого неэффективного в мире оценщика параметров гауссовского распределения. Давайте начнем.
%matplotlib inline
import torch
from torch import nn
from d2l import torch as d2l
20.1.1. Генерация «реальных» данных
Поскольку это будет самым скучным примером в мире, мы просто сгенерируем данные, взятые из гауссовского распределения.
X = torch.normal(0.0, 1, (1000, 2))
A = torch.tensor([[1, 2], [-0.1, 0.5]])
b = torch.tensor([1, 2])
data = torch.matmul(X, A) + b
Давайте посмотрим, что у нас получилось. Это должно быть гауссово распределение, сдвинутое каким-то довольно произвольным образом, со средним \(b\) и ковариационной матрицей \(A^TA\).
d2l.set_figsize()
d2l.plt.scatter(data[:100, 0].detach().numpy(), data[:100, 1].detach().numpy());
print(f'The covariance matrix is\n{torch.matmul(A.T, A)}')
batch_size = 8
data_iter = d2l.load_array((data,), batch_size)
20.1.2. Генератор
Наш генератор будет самой простой сетью — однослойной линейной моделью. Это связано с тем, что мы будем питать эту линейную сеть с помощью генератора гауссовских данных. Следовательно, ей буквально нужно лишь выучить параметры, чтобы идеально имитировать данные.
net_G = nn.Sequential(nn.Linear(2, 2))
20.1.3. Дискриминатор
Для дискриминатора мы будем немного более избирательными: мы используем многослойный перцептрон с тремя слоями, чтобы сделать задачу чуть более интересной.
net_D = nn.Sequential(
    nn.Linear(2, 5), nn.Tanh(),
    nn.Linear(5, 3), nn.Tanh(),
    nn.Linear(3, 1))
20.1.4. Обучение
Сначала определим функцию для обновления дискриминатора.
#@save
def update_D(X, Z, net_D, net_G, loss, trainer_D):
    """Update discriminator."""
    batch_size = X.shape[0]
    ones = torch.ones((batch_size,), device=X.device)
    zeros = torch.zeros((batch_size,), device=X.device)
    trainer_D.zero_grad()
    real_Y = net_D(X)
    fake_X = net_G(Z)
    # Do not need to compute gradient for `net_G`, detach it from
    # computing gradients.
    fake_Y = net_D(fake_X.detach())
    loss_D = (loss(real_Y, ones.reshape(real_Y.shape)) +
              loss(fake_Y, zeros.reshape(fake_Y.shape))) / 2
    loss_D.backward()
    trainer_D.step()
    return loss_D
Генератор обновляется аналогичным образом. Здесь мы повторно используем перекрёстную энтропию, но меняем метку для поддельных данных с \(0\) на \(1\).
#@save
def update_G(Z, net_D, net_G, loss, trainer_G):
    """Update generator."""
    batch_size = Z.shape[0]
    ones = torch.ones((batch_size,), device=Z.device)
    trainer_G.zero_grad()
    # We could reuse `fake_X` from `update_D` to save computation
    fake_X = net_G(Z)
    # Recomputing `fake_Y` is needed since `net_D` is changed
    fake_Y = net_D(fake_X)
    loss_G = loss(fake_Y, ones.reshape(fake_Y.shape))
    loss_G.backward()
    trainer_G.step()
    return loss_G
И дискриминатор, и генератор выполняют бинарную логистическую регрессию с перекрёстной энтропией в качестве функции потерь. Для сглаживания процесса обучения мы используем оптимизатор Adam. На каждой итерации мы сначала обновляем дискриминатор, а затем генератор. Мы визуализируем обе функции потерь и сгенерированные примеры.
def train(net_D, net_G, data_iter, num_epochs, lr_D, lr_G, latent_dim, data):
    loss = nn.BCEWithLogitsLoss(reduction='sum')
    for w in net_D.parameters():
        nn.init.normal_(w, 0, 0.02)
    for w in net_G.parameters():
        nn.init.normal_(w, 0, 0.02)
    trainer_D = torch.optim.Adam(net_D.parameters(), lr=lr_D)
    trainer_G = torch.optim.Adam(net_G.parameters(), lr=lr_G)
    animator = d2l.Animator(xlabel='epoch', ylabel='loss',
                            xlim=[1, num_epochs], nrows=2, figsize=(5, 5),
                            legend=['discriminator', 'generator'])
    animator.fig.subplots_adjust(hspace=0.3)
    for epoch in range(num_epochs):
        # Train one epoch
        timer = d2l.Timer()
        metric = d2l.Accumulator(3)  # loss_D, loss_G, num_examples
        for (X,) in data_iter:
            batch_size = X.shape[0]
            Z = torch.normal(0, 1, size=(batch_size, latent_dim))
            metric.add(update_D(X, Z, net_D, net_G, loss, trainer_D),
                       update_G(Z, net_D, net_G, loss, trainer_G),
                       batch_size)
        # Visualize generated examples
        Z = torch.normal(0, 1, size=(100, latent_dim))
        fake_X = net_G(Z).detach().numpy()
        animator.axes[1].cla()
        animator.axes[1].scatter(data[:, 0], data[:, 1])
        animator.axes[1].scatter(fake_X[:, 0], fake_X[:, 1])
        animator.axes[1].legend(['real', 'generated'])
        # Show the losses
        loss_D, loss_G = metric[0]/metric[2], metric[1]/metric[2]
        animator.add(epoch + 1, (loss_D, loss_G))
    print(f'loss_D {loss_D:.3f}, loss_G {loss_G:.3f}, '
          f'{metric[2] / timer.stop():.1f} examples/sec')
Теперь зададим гиперпараметмы для подгонки гауссова распределения.
lr_D, lr_G, latent_dim, num_epochs = 0.05, 0.005, 2, 20
train(net_D, net_G, data_iter, num_epochs, lr_D, lr_G,
      latent_dim, data[:100].detach().numpy())
20.1.5. Итоги
Генеративно-состязательные сети (GANs) состоят из двух глубоких сетей: генератора и дискриминатора.
Генератор создаёт изображение, максимально близкое к истинному, чтобы обмануть дискриминатор, путём максимизации функции потерь перекрёстной энтропии, т. е., \(\max \log(D(\mathbf{x'}))\).
Дискриминатор пытается отличить сгенерированные изображения от истинных, минимизируя функцию потерь перекрёстной энтропии, т. е., \(\min - y \log D(\mathbf{x}) - (1-y)\log(1-D(\mathbf{x}))\).
20.1.6. Упражнения
Существует ли равновесие, при котором выигрывает генератор, т. е. дискриминатор оказывается неспособным различить два распределения на конечных выборках?