
8.6. Остаточные сети (ResNet) и ResNeXt
По мере того как мы проектируем всё более глубокие сети, становится важно понять, как добавление слоёв может повысить сложность и выразительную способность сети. Ещё более важно уметь проектировать сети, в которых добавление слоёв делает их строго более выразительными, а не просто иными. Чтобы продвинуться вперёд, нам потребуется немного математики.
import torch
from torch import nn
from torch.nn import functional as F
from d2l import torch as d2l
8.6.1. Классы функций
Рассмотрим \(\mathcal{F}\) — класс функций, который может быть достигнут конкретной архитектурой сети (вместе с настройками скорости обучения и другими гиперпараметрами). То есть, для любого \(f \in \mathcal{F}\) существует некоторый набор параметров (например, весов и смещений), который может быть получен в результате обучения на подходящем наборе данных. Предположим, что \(f^*\) — это «истинная» функция, которую мы действительно хотели бы найти. Если она находится в \(\mathcal{F}\), то нам повезло, но обычно нам не везёт настолько. Вместо этого мы постараемся найти какой-то \(f^*_\mathcal{F}\), который является нашим лучшим вариантом в рамках \(\mathcal{F}\). Например, имея набор данных с признаками \(\mathbf{X}\) и метками \(\mathbf{y}\), мы можем попытаться найти его, решая следующую задачу оптимизации:
Мы знаем, что регуляризация (Morozov, 1984, Tikhonov and Arsenin, 1977) может контролировать сложность \(\mathcal{F}\) и обеспечивать сходимость, поэтому больший объём обучающих данных, как правило, приводит к лучшим \(f^*_\mathcal{F}\). Логично предположить, что если мы спроектируем другую, более мощную архитектуру \(\mathcal{F}'\), то получим лучший результат. Иными словами, мы ожидаем, что \(f^*_{\mathcal{F}'}\) будет «лучше», чем \(f^*_{\mathcal{F}}\). Однако, если \(\mathcal{F} \not\subseteq \mathcal{F}'\), нет никаких гарантий, что это произойдет. Более того, \(f^*_{\mathcal{F}'}\) может оказаться даже хуже. Как показано на Fig. 8.6.1, для не вкладывающихся друг в друга классов функций больший класс функций не всегда приближает нас к функции «истины» \(f^*\). Например, на левой части рисунка Fig. 8.6.1, хотя \(\mathcal{F}_3\) ближе к \(f^*\), чем \(\mathcal{F}_1\), \(\mathcal{F}_6\) удаляется от цели, и нет гарантии, что дальнейшее увеличение сложности позволит уменьшить расстояние до \(f^*\). В случае вкладывающихся друг в друга классов функций, где \(\mathcal{F}_1 \subseteq \cdots \subseteq \mathcal{F}_6\) на правой части рисунка Fig. 8.6.1, мы можем избежать вышеописанной проблемы, характерной для не вкладывающихся классов функций.
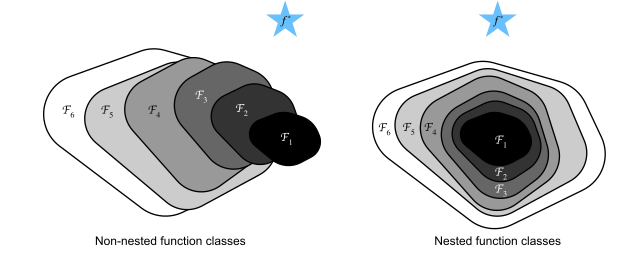
Fig. 8.6.1 Для невложенных классов функций больший (обозначен площадью) класс функций не гарантирует, что мы приблизимся к функции «истины» (\(\mathit{f}^*\)). В случае вложенных классов функций это происходит.
Таким образом, мы гарантированно увеличиваем выразительную способность сети только в том случае, если более широкие классы функций содержат более узкие. Для глубоких нейронных сетей, если мы можем обучить вновь добавленный слой так, чтобы он реализовал тождественное отображение \(f(\mathbf{x}) = \mathbf{x}\), новая модель будет столь же эффективна, как и исходная. Поскольку новая модель может найти лучшее решение для аппроксимации набора данных для обучения, добавленный слой может способствовать снижению ошибки на обучающей выборке.
Этим вопросом занимались авторы работы He et al. (2016) при создании сверхглубоких моделей для компьютерного зрения. В основе предложенной ими остаточной сети (ResNet) лежит идея о том, что каждый добавленный слой должен с большей легкостью содержать тождественную функцию в качестве одного из своих элементов. Эти соображения оказались довольно глубокими, однако они привели к удивительно простому решению — остаточному блоку. Благодаря ему ResNet выиграла соревнование ImageNet Large Scale Visual Recognition Challenge в 2015 году. Этот подход оказал глубокое влияние на методы построения глубоких нейронных сетей. Например, остаточные блоки были добавлены в рекуррентные сети (Kim et al., 2017, Prakash et al., 2016). Аналогичным образом, архитектуры Transformer (Vaswani et al., 2017) используют их для эффективного стекирования множества слоёв. Они также применяются в графовых нейронных сетях (Kipf and Welling, 2016) и, являясь базовой концепцией, широко используются в компьютерном зрении (Redmon and Farhadi, 2018, Ren et al., 2015). Обратите внимание, что остаточным сетям предшествовали магистральные сети (highway networks) (Srivastava et al., 2015), которые разделяли некоторые мотивационные идеи, хотя и не обладали элегантной параметризацией вокруг тождественной функции.
8.6.2. Блоки остаточных связей
Рассмотрим локальный фрагмент нейронной сети, как показано на рисунке Fig. 8.6.2. Обозначим вход через \(\mathbf{x}\). Будем считать, что \(f(\mathbf{x})\) — желаемое базовое отображение, которое мы хотим получить в результате обучения, — подается на вход функции активации, расположенной сверху. На левой части схемы блок, выделенный пунктирной рамкой, должен напрямую обучаться отображению \(f(\mathbf{x})\). На правой части блока, выделенного пунктирной рамкой, необходимо обучить остаточное отображение \(g(\mathbf{x}) = f(\mathbf{x}) - \mathbf{x}\), что и дало название остаточному блоку. Если тождественное отображение \(f(\mathbf{x}) = \mathbf{x}\) является желаемым базовым отображением, то остаточное отображение сводится к \(g(\mathbf{x}) = 0\), и его, следовательно, легче обучить: нам достаточно лишь обнулить веса и смещения верхнего слоя (например, полносвязного слоя или свёрточного слоя), находящегося внутри пунктирной рамки. Правая часть рисунка иллюстрирует остаточный блок ResNet, где сплошная линия, соединяющая вход слоя \(\mathbf{x}\) с оператором сложения, называется остаточной связью (или связью-коротким путем). Благодаря остаточным блокам входные данные могут быстрее распространяться вперед по остаточным связям между слоями. Фактически остаточный блок можно рассматривать как частный случай многовходового блока Inception: он имеет две ветви, одна из которых представляет собой тождественное отображение.
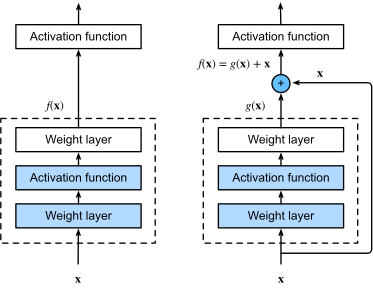
Fig. 8.6.2 В обычном блоке (слева) часть внутри пунктирной рамки должна напрямую изучать отображение \(\mathit{f}(\mathbf{x})\). В остаточном блоке (справа) часть внутри пунктирной рамки должна изучать остаточное отображение \(\mathit{g}(\mathbf{x}) = \mathit{f}(\mathbf{x}) - \mathbf{x}\), что облегчает обучение тождественного отображения \(\mathit{f}(\mathbf{x}) = \mathbf{x}\).
ResNet использует полную архитектуру свёрточных слоёв VGG \(3\times 3\). Блок residual состоит из двух свёрточных слоёв \(3\times 3\) с одинаковым числом выходных каналов. После каждого свёрточного слоя следуют слой батч-нормализации и функция активации ReLU. Затем мы пропускаем эти две свёрточные операции и прибавляем входные данные непосредственно перед финальной функцией активации ReLU. Такая конструкция требует, чтобы форма выхода двух свёрточных слоёв совпадала с формой входа, чтобы их можно было сложить. Если мы хотим изменить число каналов, нам необходимо ввести дополнительный свёрточный слой \(1\times 1\), который преобразует входные данные в нужную форму для операции сложения. Рассмотрим код ниже.
class Residual(nn.Module):  #@save
    """The Residual block of ResNet models."""
    def __init__(self, num_channels, use_1x1conv=False, strides=1):
        super().__init__()
        self.conv1 = nn.LazyConv2d(num_channels, kernel_size=3, padding=1,
                                   stride=strides)
        self.conv2 = nn.LazyConv2d(num_channels, kernel_size=3, padding=1)
        if use_1x1conv:
            self.conv3 = nn.LazyConv2d(num_channels, kernel_size=1,
                                       stride=strides)
        else:
            self.conv3 = None
        self.bn1 = nn.LazyBatchNorm2d()
        self.bn2 = nn.LazyBatchNorm2d()

    def forward(self, X):
        Y = F.relu(self.bn1(self.conv1(X)))
        Y = self.bn2(self.conv2(Y))
        if self.conv3:
            X = self.conv3(X)
        Y += X
        return F.relu(Y)
Этот код генерирует два типа сетей: в одной вход добавляется к выходу
перед применением нелинейности ReLU, если выполняется условие
use_1x1conv=False; а в другой количество каналов и разрешение
изменяются с помощью свёртки \(1 \times 1\) перед сложением.
Fig. 8.6.3 иллюстрирует это.
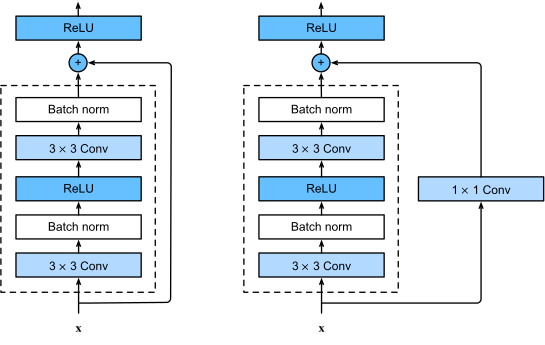
Fig. 8.6.3 Блок ResNet со свёрткой \(1 \times 1\) и без неё, преобразующей входные данные в нужную форму для операции сложения.
Теперь рассмотрим случай, когда входные и выходные данные имеют одинаковую форму, при котором свёртка \(1 \times 1\) не требуется.
blk = Residual(3)
X = torch.randn(4, 3, 6, 6)
blk(X).shape
Мы также можем уменьшить высоту и ширину выхода вдвое, одновременно
увеличив число выходных каналов. В этом случае мы используем свёртки
\(1 \times 1\) через use_1x1conv=True. Это удобно в начале
каждого блока ResNet для уменьшения пространственной размерности с
помощью strides=2.
blk = Residual(6, use_1x1conv=True, strides=2)
blk(X).shape
8.6.3. Модель ResNet
Первые два слоя ResNet совпадают с аналогичными слоями GoogLeNet, описанными ранее: за свёрточным слоем \(7\times 7\) с 64 выходными каналами и шагом 2 следует слой максимального пулинга \(3\times 3\) с шагом 2. Отличие заключается в том, что в ResNet после каждого свёрточного слоя добавлен слой батч-нормализации.
class ResNet(d2l.Classifier):
    def b1(self):
        return nn.Sequential(
            nn.LazyConv2d(64, kernel_size=7, stride=2, padding=3),
            nn.LazyBatchNorm2d(), nn.ReLU(),
            nn.MaxPool2d(kernel_size=3, stride=2, padding=1))
GoogLeNet использует четыре модуля, состоящих из блоков Inception. Однако ResNet использует четыре модуля, состоящих из остаточных блоков, каждый из которых включает несколько остаточных блоков с одинаковым числом выходных каналов. Число каналов в первом модуле равно числу входных каналов. Поскольку уже был использован слой максимального пулинга с шагом 2, уменьшать высоту и ширину не требуется. В первом остаточном блоке каждого из последующих модулей число каналов удваивается по сравнению с предыдущим модулем, а высота и ширина уменьшаются вдвое.
@d2l.add_to_class(ResNet)
def block(self, num_residuals, num_channels, first_block=False):
    blk = []
    for i in range(num_residuals):
        if i == 0 and not first_block:
            blk.append(Residual(num_channels, use_1x1conv=True, strides=2))
        else:
            blk.append(Residual(num_channels))
    return nn.Sequential(*blk)
Затем мы добавляем все модули в ResNet. Для каждого модуля используются два остаточных блока. Наконец, как и в GoogLeNet, мы добавляем слой глобального пулинга, за которым следует полносвязный слой.
@d2l.add_to_class(ResNet)
def __init__(self, arch, lr=0.1, num_classes=10):
    super(ResNet, self).__init__()
    self.save_hyperparameters()
    self.net = nn.Sequential(self.b1())
    for i, b in enumerate(arch):
        self.net.add_module(f'b{i+2}', self.block(*b, first_block=(i==0)))
    self.net.add_module('last', nn.Sequential(
        nn.AdaptiveAvgPool2d((1, 1)), nn.Flatten(),
        nn.LazyLinear(num_classes)))
    self.net.apply(d2l.init_cnn)
В каждом модуле содержится четыре свёрточных слоя (исключая свёрточный слой \(1\times 1\)). Вместе с первым свёрточным слоем \(7\times 7\) и финальным полносвязным слоем общее количество слоёв составляет 18. Поэтому эту модель обычно называют ResNet-18. Настраивая различное количество каналов и блоков остаточных связей в модуле, мы можем создавать различные модели ResNet, такие как более глубокая ResNet-152, состоящая из 152 слоёв. Хотя основная архитектура ResNet схожа с архитектурой GoogLeNet, структура ResNet проще и легче поддается модификации. Все эти факторы привели к быстрому и широкому распространению ResNet. Fig. 8.6.4 изображает полную архитектуру ResNet-18.
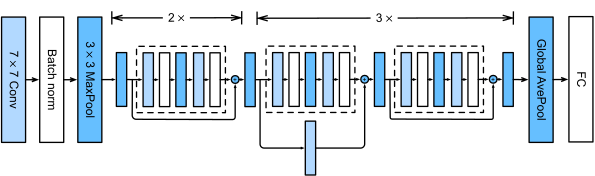
Fig. 8.6.4 Архитектура ResNet-18.
Прежде чем приступить к обучению ResNet, давайте рассмотрим, как изменяется форма входных данных в различных модулях ResNet. Как и во всех предыдущих архитектурах, разрешение уменьшается, а количество каналов увеличивается до тех пор, пока слой глобального усредняющего пулинга не агрегирует все признаки.
class ResNet18(ResNet):
    def __init__(self, lr=0.1, num_classes=10):
        super().__init__(((2, 64), (2, 128), (2, 256), (2, 512)),
                       lr, num_classes)
ResNet18().layer_summary((1, 1, 96, 96))
8.6.4. Обучение
Мы обучаем ResNet на наборе данных Fashion-MNIST, как и раньше. ResNet — довольно мощная и гибкая архитектура. График, отображающий потери при обучении и валидации, демонстрирует значительный разрыв между обеими кривыми, причём потери при обучении существенно ниже. Для сети такой гибкости дополнительные обучающие данные могли бы существенно сократить этот разрыв и повысить точность.
model = ResNet18(lr=0.01)
trainer = d2l.Trainer(max_epochs=10, num_gpus=1)
data = d2l.FashionMNIST(batch_size=128, resize=(96, 96))
model.apply_init([next(iter(data.get_dataloader(True)))[0]], d2l.init_cnn)
trainer.fit(model, data)
8.6.5. ResNeXt
Одной из проблем, возникающих при проектировании ResNet, является компромисс между нелинейностью и размерностью внутри заданного блока. То есть мы можем увеличить нелинейность, добавляя слои или расширяя свёртки. Альтернативная стратегия заключается в увеличении числа каналов, по которым информация передаётся между блоками. К сожалению, этот подход сопряжён с квадратичными затратами, поскольку вычислительная стоимость преобразования \(c_\textrm{i}\) каналов в \(c_\textrm{o}\) пропорциональна \(\mathcal{O}(c_\textrm{i} \cdot c_\textrm{o})\) (см. наше обсуждение в Section 7.4).
Мы можем почерпнуть вдохновение из блока Inception Fig. 8.4.1, в котором информация проходит через блок в отдельных группах. Применение идеи нескольких независимых групп к блоку ResNet Fig. 8.6.3 привело к созданию архитектуры ResNeXt (Xie et al., 2017). В отличие от разнообразия преобразований в Inception, ResNeXt использует одно и то же преобразование во всех ветвях, что минимизирует необходимость ручной настройки каждой из них.
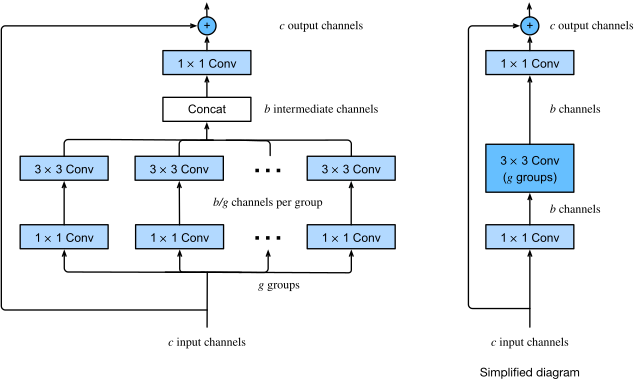
Fig. 8.6.5 Блок ResNeXt. Использование свёртки с группами \(\mathit{g}\) выполняется в \(\mathit{g}\) раз быстрее, чем плотная свёртка. Это блок-бутылочное горлышко с остаточными связями, если количество промежуточных каналов \(\mathit{b}\) меньше \(\mathit{c}\).
Разбиение свёртки с \(c_\textrm{i}\) на \(c_\textrm{o}\) каналов на свёртку с \(g\) группами размера \(c_\textrm{i}/g\), генерирующую \(g\) выходов размера \(c_\textrm{o}/g\), называется, что вполне уместно, свёрткой с группами. Вычислительная стоимость (пропорционально) снижается с \(\mathcal{O}(c_\textrm{i} \cdot c_\textrm{o})\) до \(\mathcal{O}(g \cdot (c_\textrm{i}/g) \cdot (c_\textrm{o}/g)) = \mathcal{O}(c_\textrm{i} \cdot c_\textrm{o} / g)\), то есть вычисления становятся в \(g\) раз быстрее. Ещё лучше то, что количество параметров, необходимых для генерации выхода, также уменьшается с одной \(c_\textrm{i} \times c_\textrm{o}\) матрицы до \(g\) меньших матриц размера \((c_\textrm{i}/g) \times (c_\textrm{o}/g)\), что снова представляет собой снижение в \(g\) раз. В дальнейшем мы предполагаем, что как \(c_\textrm{i}\), так и \(c_\textrm{o}\) делятся на \(g\).
Единственная проблема такого подхода заключается в том, что информация не обменивается между группами \(g\). Блок ResNeXt из Fig. 8.6.5 исправляет это двумя способами: сгруппированная свёртка с ядром размера \(3 \times 3\) помещается между двумя свёртками \(1 \times 1\). Вторая из них выполняет двойную функцию, возвращая исходное количество каналов. Преимущество заключается в том, что мы платим лишь за стоимость вычислений \(\mathcal{O}(c \cdot b)\) для ядер размера \(1 \times 1\) и можем довольствоваться стоимостью \(\mathcal{O}(b^2 / g)\) для ядер размера \(3 \times 3\). Аналогично реализации остаточного блока в Section 8.6.2, остаточная связь заменена (и, следовательно, обобщена) с помощью свёртки \(1 \times 1\).
На правой диаграмме Fig. 8.6.5 представлено гораздо более компактное описание получившегося блока сети. Этот подход также сыграет ключевую роль в проектировании современных универсальных свёрточных нейронных сетей (CNN), рассматриваемых в Section 8.8. Обратите внимание, что идея группированных свёрток восходит к реализации AlexNet (Krizhevsky et al., 2012). При распределении сети между двумя видеокартами с ограниченной памятью каждая видеокарта рассматривалась как отдельный канал, что не приводило к негативным последствиям.
В следующей реализации класса ResNeXtBlock в качестве аргумента
задаётся groups (\(g\)), а также количество промежуточных
(узких) каналов bot_channels (\(b\)). Наконец, когда необходимо
уменьшить высоту и ширину представления, мы добавляем шаг \(2\),
устанавливая use_1x1conv=True, strides=2.
class ResNeXtBlock(nn.Module):  #@save
    """The ResNeXt block."""
    def __init__(self, num_channels, groups, bot_mul, use_1x1conv=False,
                 strides=1):
        super().__init__()
        bot_channels = int(round(num_channels * bot_mul))
        self.conv1 = nn.LazyConv2d(bot_channels, kernel_size=1, stride=1)
        self.conv2 = nn.LazyConv2d(bot_channels, kernel_size=3,
                                   stride=strides, padding=1,
                                   groups=bot_channels//groups)
        self.conv3 = nn.LazyConv2d(num_channels, kernel_size=1, stride=1)
        self.bn1 = nn.LazyBatchNorm2d()
        self.bn2 = nn.LazyBatchNorm2d()
        self.bn3 = nn.LazyBatchNorm2d()
        if use_1x1conv:
            self.conv4 = nn.LazyConv2d(num_channels, kernel_size=1,
                                       stride=strides)
            self.bn4 = nn.LazyBatchNorm2d()
        else:
            self.conv4 = None

    def forward(self, X):
        Y = F.relu(self.bn1(self.conv1(X)))
        Y = F.relu(self.bn2(self.conv2(Y)))
        Y = self.bn3(self.conv3(Y))
        if self.conv4:
            X = self.bn4(self.conv4(X))
        return F.relu(Y + X)
Его применение полностью аналогично применению ResNetBlock,
рассмотренному ранее. Например, при использовании
(use_1x1conv=False, strides=1) входные и выходные данные имеют
одинаковую форму. В то же время установка
use_1x1conv=True, strides=2 уменьшает высоту и ширину выходных
данных вдвое.
blk = ResNeXtBlock(32, 16, 1)
X = torch.randn(4, 32, 96, 96)
blk(X).shape
8.6.6. Итоги и обсуждение
Вложенные классы функций предпочтительны, поскольку они позволяют получать строго более мощные, а не просто отличающиеся классы функций при увеличении ёмкости. Одним из способов достижения этого является возможность дополнительных слоёв просто пропускать входные данные на выход. Остаточные связи обеспечивают такую возможность. В результате это изменяет индуктивное смещение: вместо того чтобы простые функции имели вид \(f(\mathbf{x}) = 0\), простые функции теперь стремятся выглядеть как \(f(\mathbf{x}) = \mathbf{x}\).
Остаточное отображение может легче изучать функцию тождества, например, путем приведения параметров в слое весов к нулю. Мы можем обучать эффективные глубокие нейронные сети, используя остаточные блоки. Входные данные могут быстрее распространяться вперед через остаточные связи между слоями. В результате мы можем обучать гораздо более глубокие сети. Например, в оригинальной статье о ResNet (He et al., 2016) допускалось использование до 152 слоёв. Ещё одним преимуществом остаточных сетей является возможность добавлять слои, инициализированные как функция тождества, во время процесса обучения. В конце концов, поведение слоя по умолчанию заключается в том, чтобы пропускать данные без изменений. В некоторых случаях это может ускорить обучение очень больших сетей.
До появления остаточных связей для эффективного обучения магистральных сетей (highway networks) с более чем 100 слоями использовались обходные пути с вентильными блоками (Srivastava et al., 2015). Использование функций тождества в качестве обходных путей позволило ResNet продемонстрировать выдающиеся результаты в нескольких задачах компьютерного зрения. Остаточные связи оказали значительное влияние на архитектуру последующих глубоких нейронных сетей, будь то свёрточные или последовательные. Как мы рассмотрим позже, архитектура трансформера (Vaswani et al., 2017) также использует остаточные связи (вместе с другими архитектурными решениями) и широко применяется в таких разнообразных областях, как обработка естественного языка, компьютерное зрение, распознавание речи и обучение с подкреплением.
ResNeXt — это пример того, как со временем эволюционировал дизайн свёрточных нейронных сетей: благодаря более экономному использованию вычислений и их компромиссу с размером активаций (числом каналов) он позволяет создавать более быстрые и точные сети при меньших затратах. Альтернативный взгляд на групповые свёртки заключается в рассмотрении блочно-диагональной матрицы весов свёртки. Обратите внимание, что существует довольно много подобных «трюков», ведущих к созданию более эффективных сетей. Например, ShiftNet (Wu et al., 2018) имитирует эффекты свёртки \(3 \times 3\), просто добавляя сдвинутые активации к каналам, что увеличивает сложность функции без каких-либо дополнительных вычислительных затрат.
Общей чертой рассмотренных нами архитектур является то, что проектирование нейронной сети достаточно сильно зависит от ручного труда и в значительной степени опирается на изобретательность разработчика при поиске «правильных» гиперпараметров. Хотя такой подход вполне осуществим, он требует значительных временных затрат и не гарантирует, что результат будет оптимальным в каком-либо смысле. В Section 8.8 мы обсудим ряд стратегий получения высококачественных сетей в более автоматизированном режиме. В частности, мы рассмотрим понятие пространства архитектур, которое привело к созданию моделей RegNetX/Y (Radosavovic et al., 2020).
8.6.7. Упражнения
Каковы основные различия между блоком Inception из Fig. 8.4.1 и остаточным блоком? Как они соотносятся с точки зрения вычислительной сложности, точности и классов функций, которые они могут описывать?
Обратитесь к таблице 1 в статье о ResNet (He et al., 2016), чтобы реализовать различные варианты сети.
Для более глубоких сетей ResNet использует архитектуру «бутылочного горлышка» (bottleneck) для снижения вычислительной сложности модели. Попробуйте реализовать её.
В последующих версиях ResNet авторы изменили структуру «свёртка, батч-нормализация и активация» на структуру «батч-нормализация, активация и свёртка». Реализуйте это улучшение самостоятельно. Подробности см. на рисунке 1 в He et al. (2016).
Почему мы не можем просто неограниченно увеличивать сложность функций, даже если классы функций вложены друг в друга?