
16.2. Анализ тональности: использование рекуррентных нейронных сетей
Как и в задачах на определение сходства слов и аналогий, мы можем применять предобученные векторные представления слов к анализу тональности. Поскольку набор данных с отзывами IMDb в Section 16.1 невелик, использование текстовых представлений, предобученных на крупномасштабных корпусах, может снизить переобучение модели. В качестве конкретного примера, проиллюстрированного в Fig. 16.2.1, мы будем представлять каждый токен с помощью предобученной модели GloVe и подавать эти представления в многослойный двунаправленный RNN для получения представления текстовой последовательности, которое затем преобразуется в выходные данные анализа тональности (Maas et al., 2011). Для той же задачи последующей обработки мы рассмотрим другой архитектурный подход позже.
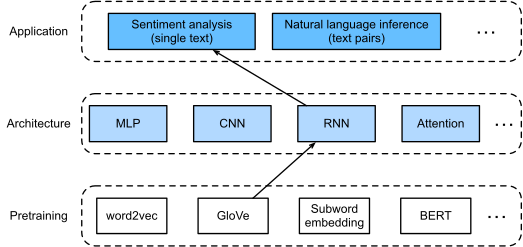
Fig. 16.2.1 В этом разделе мы используем предварительно обученные векторы GloVe в архитектуре на основе рекуррентной нейронной сети для анализа тональности.
import torch
from torch import nn
from d2l import torch as d2l

batch_size = 64
train_iter, test_iter, vocab = d2l.load_data_imdb(batch_size)
16.2.1. Представление одного текста с помощью RNN
В задачах классификации текстов, таких как анализ тональности,
последовательность текста переменной длины преобразуется в категории
фиксированной длины. В следующем примере BiRNN, хотя каждый токен
текстовой последовательности получает своё собственное предобученное
представление GloVe через слой эмбеддинга (self.embedding), вся
последовательность кодируется двунаправленным RNN (self.encoder).
Более конкретно, скрытые состояния (на последнем слое) двунаправленного
LSTM как на начальном, так и на конечном временных шагах объединяются
для формирования представления текстовой последовательности. Это единое
представление текста затем преобразуется в выходные категории с помощью
полносвязного слоя (self.decoder) с двумя выходами («положительный»
и «отрицательный»).
class BiRNN(nn.Module):
    def __init__(self, vocab_size, embed_size, num_hiddens,
                 num_layers, **kwargs):
        super(BiRNN, self).__init__(**kwargs)
        self.embedding = nn.Embedding(vocab_size, embed_size)
        # Set `bidirectional` to True to get a bidirectional RNN
        self.encoder = nn.LSTM(embed_size, num_hiddens, num_layers=num_layers,
                                bidirectional=True)
        self.decoder = nn.Linear(4 * num_hiddens, 2)

    def forward(self, inputs):
        # The shape of `inputs` is (batch size, no. of time steps). Because
        # LSTM requires its input's first dimension to be the temporal
        # dimension, the input is transposed before obtaining token
        # representations. The output shape is (no. of time steps, batch size,
        # word vector dimension)
        embeddings = self.embedding(inputs.T)
        self.encoder.flatten_parameters()
        # Returns hidden states of the last hidden layer at different time
        # steps. The shape of `outputs` is (no. of time steps, batch size,
        # 2 * no. of hidden units)
        outputs, _ = self.encoder(embeddings)
        # Concatenate the hidden states at the initial and final time steps as
        # the input of the fully connected layer. Its shape is (batch size,
        # 4 * no. of hidden units)
        encoding = torch.cat((outputs[0], outputs[-1]), dim=1)
        outs = self.decoder(encoding)
        return outs
Давайте построим двунаправленную RNN с двумя скрытыми слоями для представления отдельного текста в задаче анализа тональности.
embed_size, num_hiddens, num_layers, devices = 100, 100, 2, d2l.try_all_gpus()
net = BiRNN(len(vocab), embed_size, num_hiddens, num_layers)
def init_weights(module):
    if type(module) == nn.Linear:
        nn.init.xavier_uniform_(module.weight)
    if type(module) == nn.LSTM:
        for param in module._flat_weights_names:
            if "weight" in param:
                nn.init.xavier_uniform_(module._parameters[param])
net.apply(init_weights);
16.2.2. Загрузка предобученных векторов слов
Ниже мы загружаем предварительно обученные 100-мерные (размерность
должна совпадать с embed_size) векторные представления GloVe для
токенов из словаря.
glove_embedding = d2l.TokenEmbedding('glove.6b.100d')
Выведите форму векторов для всех токенов в словаре.
embeds = glove_embedding[vocab.idx_to_token]
embeds.shape
Мы используем эти предварительно обученные векторы слов для представления токенов в отзывах и не будем обновлять их во время обучения.
net.embedding.weight.data.copy_(embeds)
net.embedding.weight.requires_grad = False
16.2.3. Обучение и оценка модели
Теперь мы можем обучить двунаправленную RNN для анализа тональности.
lr, num_epochs = 0.01, 5
trainer = torch.optim.Adam(net.parameters(), lr=lr)
loss = nn.CrossEntropyLoss(reduction="none")
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs, devices)
Определим следующую функцию для предсказания тональности текстовой
последовательности с помощью обученной модели net.
#@save
def predict_sentiment(net, vocab, sequence):
    """Predict the sentiment of a text sequence."""
    sequence = torch.tensor(vocab[sequence.split()], device=d2l.try_gpu())
    label = torch.argmax(net(sequence.reshape(1, -1)), dim=1)
    return 'positive' if label == 1 else 'negative'
Наконец, давайте используем обученную модель для предсказания тональности двух простых предложений.
predict_sentiment(net, vocab, 'this movie is so great')
predict_sentiment(net, vocab, 'this movie is so bad')
16.2.4. Итоги
Предобученные векторные представления слов могут представлять отдельные токены в последовательности текста.
Двусторонние рекуррентные нейронные сети могут представлять текстовую последовательность, например, путем объединения её скрытых состояний на начальном и конечном временных шагах. Это единое представление текста можно преобразовать в категории с помощью полносвязного слоя.
16.2.5. Упражнения
Увеличьте количество эпох. Удается ли улучшить точность на обучающих и тестовых данных? А как насчет настройки других гиперпараметров?
Используйте более крупные предобученные векторные представления слов, например, 300-мерные эмбеддинги GloVe. Улучшает ли это точность классификации?
Можно ли повысить точность классификации, используя токенизацию spaCy? Для этого необходимо установить spaCy (
pip install spacy) и английский пакет (python -m spacy download en). В коде сначала импортируйте spaCy (import spacy). Затем загрузите английский пакет spaCy (spacy_en = spacy.load('en')). Наконец, определите функциюdef tokenizer(text): return [tok.text for tok in spacy_en.tokenizer(text)]и замените ею исходную функциюtokenizer. Обратите внимание на различия в представлении фразовых токенов в GloVe и spaCy. Например, фразовый токен “new york” в GloVe имеет вид “new-york”, а после токенизации spaCy он сохраняет форму “new york”.