
3.6. Обобщающая способность
Рассмотрим двух студентов колледжа, усердно готовящихся к финальному экзамену. Обычно такая подготовка включает практику и проверку своих способностей путем решения экзаменационных заданий прошлых лет. Тем не менее, успешное выполнение заданий прошлых экзаменов не гарантирует, что они покажут высокие результаты, когда это действительно важно. Например, представьте студентку, Элли, чья подготовка заключалась исключительно в заучивании ответов на вопросы прошлых экзаменов. Даже если бы Элли обладала выдающейся памятью и могла бы идеально воспроизводить ответы на любые ранее встречавшиеся вопросы, она всё равно может растеряться перед новым (ранее не встречавшимся) вопросом. Для сравнения, представьте другую студентку, Индуктивную Ирину, с аналогично слабыми навыками запоминания, но с талантом к выявлению закономерностей. Обратите внимание, что если бы экзамен действительно состоял из повторно используемых вопросов прошлых лет, Элли легко превзошла бы Ирину. Даже если бы выявленные Ириной закономерности давали 90% точных предсказаний, они всё равно не могли бы конкурировать с 100% запоминанием Элли. Однако, даже если бы экзамен полностью состоял из новых вопросов, Ирина могла бы сохранить свой средний результат на уровне 90%.
Как ученые в области машинного обучения, наша цель — обнаруживать закономерности. Но как мы можем быть уверены, что действительно нашли общую закономерность, а не просто запомнили данные? В большинстве случаев наши прогнозы полезны лишь тогда, когда модель выявляет такую закономерность. Мы хотим предсказывать цены на акции не на вчерашний день, а на завтрашний. Нам нужно распознавать не уже диагностированные заболевания у ранее виденных пациентов, а ранее не диагностированные болезни у ранее не встречавшихся пациентов. Эта проблема — как обнаруживать закономерности, которые обобщаются (generalize) — является фундаментальной проблемой машинного обучения и, можно сказать, всей статистики. Мы можем рассматривать эту проблему как лишь один аспект гораздо более широкого вопроса, который охватывает всю науку: когда мы имеем право делать переход от частных наблюдений к более общим утверждениям?
В реальной жизни мы вынуждены обучать модели на конечном наборе данных. Типичные объёмы таких данных сильно различаются в зависимости от области применения. Для многих важных медицинских задач нам доступны лишь несколько тысяч точек данных. При изучении редких заболеваний нам может повезти, если мы сможем получить доступ к сотням примеров. Напротив, крупнейшие публичные наборы данных, состоящие из размеченных фотографий, такие как ImageNet (Deng et al., 2009), содержат миллионы изображений. А некоторые не размеченные коллекции изображений, например набор данных Flickr YFC100M, могут быть ещё больше, насчитывая более 100 миллионов изображений (Thomee et al., 2016). Однако даже при таких экстремальных масштабах количество доступных точек данных остается ничтожно малым по сравнению с пространством всех возможных изображений при разрешении в один мегапиксель. Работая с конечными выборками, мы всегда должны помнить о риске того, что мы можем переобучиться на обучающих данных, а затем обнаружить, что не смогли выявить закономерность, поддающуюся обобщению.
Явление, при котором модель подстраивается к обучающим данным сильнее, чем к лежащему в их основе распределению, называется переобучением, а методы борьбы с ним часто называют регуляризацией. Хотя это не заменяет полноценного введения в теорию статистического обучения (см. Boucheron et al. (2005), Vapnik (1998)), мы дадим вам достаточно интуиции, чтобы начать. Мы будем возвращаться к теме обобщающей способности во многих главах этой книги, исследуя как то, что известно о принципах, лежащих в основе обобщающей способности различных моделей, так и эвристические методы, которые (эмпирически) показали улучшение обобщающей способности на практически значимых задачах.
3.6.1. Ошибка на обучающей выборке и ошибка обобщающей способности
В стандартной постановке задачи обучения с учителем мы предполагаем, что обучающие и тестовые данные выбираются независимо из одинаковых распределений. Это обычно называют предположением IID. Хотя это предположение является сильным, стоит отметить, что без него мы оказались бы в тупике. Почему мы должны верить, что обучающие данные, выбранные из распределения \(P(X,Y)\), должны подсказать нам, как делать прогнозы для тестовых данных, сгенерированных другим распределением \(Q(X,Y)\)? Оказывается, такие скачки требуют сильных предположений о том, как связаны \(P\) и \(Q\). Позже мы обсудим некоторые предположения, допускающие сдвиги распределений, но сначала нам нужно понять случай IID, где \(P(\cdot) = Q(\cdot)\).
Прежде всего следует различать ошибку обучения \(R_\textrm{emp}\), которая является статистикой, вычисленной на обучающем наборе данных, и ошибку обобщения \(R\), которая представляет собой математическое ожидание относительно лежащего в основе распределения. Ошибку обобщения можно представить как результат, который вы получили бы, применив модель к бесконечному потоку дополнительных примеров данных, выбранных из того же распределения. Формально ошибка обучения выражается как сумма (с использованием той же нотации, что и в Section 3.1):
то ошибка обобщающей способности выражается в виде интеграла:
Проблема заключается в том, что мы никогда не сможем точно вычислить ошибку обобщающей способности \(R\). Никто не сообщает нам точный вид функции плотности \(p(\mathbf{x}, y)\). Более того, мы не можем получить бесконечный поток примеров данных. Таким образом, на практике мы должны оценивать ошибку обобщающей способности, применяя нашу модель к независимой тестовой выборке, состоящей из случайной выборки примеров \(\mathbf{X}'\) и меток \(\mathbf{y}'\), которые были исключены из нашей обучающей выборки. Это заключается в применении той же формулы, которая использовалась для вычисления эмпирической ошибки на обучающей выборке, но к тестовой выборке \(\mathbf{X}', \mathbf{y}'\).
Ключевой момент заключается в том, что при оценке нашего классификатора на тестовой выборке мы имеем дело с фиксированным классификатором (он не зависит от примеров тестовой выборки), поэтому оценка его ошибки сводится к задаче оценки математического ожидания. Однако то же самое нельзя сказать об обучающей выборке. Обратите внимание, что модель, которую мы получаем в итоге, явно зависит от выбора обучающей выборки, поэтому ошибка на обучающей выборке, как правило, является смещённой оценкой истинной ошибки на генеральной совокупности. Центральный вопрос обобщающей способности заключается в том, когда следует ожидать, что ошибка на обучающей выборке будет близка к ошибке на генеральной совокупности (и, следовательно, к обобщающей способности).
3.6.1.1. Сложность модели
В классической теории, когда модели просты, а данных много, ошибки обучения и обобщающей способности, как правило, близки. Однако при работе с более сложными моделями и/или меньшим количеством примеров мы ожидаем, что ошибка обучения уменьшится, а разрыв между ошибкой обучения и обобщающей способностью увеличится. Это не должно вызывать удивления. Представьте класс моделей, настолько выразительный, что для любого набора данных из \(n\) примеров можно найти набор параметров, который идеально подгоняется под произвольные метки, даже если они назначены случайным образом. В этом случае, даже если мы идеально подгоним модель под обучающие данные, как мы можем сделать какие-либо выводы об обобщающей способности? Насколько нам известно, ошибка обобщающей способности может оказаться не лучше случайного угадывания.
В общем случае, без каких-либо ограничений на класс моделей, мы не можем сделать вывод, что модель выявила какую-либо обобщаемую закономерность, основываясь лишь на её подгонке под данные обучения (Vapnik et al., 1994). С другой стороны, если бы класс моделей не мог подгоняться под произвольные метки, это означало бы, что он действительно выявил закономерность. Идеи теории обучения о сложности моделей вдохновлялись идеями Карла Поппера, влиятельного философа науки, который формализовал критерий фальсифицируемости. Согласно Попперу, теория, способная объяснить любые и все наблюдения, не является научной теорией вообще! В конце концов, что она рассказала нам о мире, если не исключила ни одной возможности? Короче говоря, нам нужна гипотеза, которая не могла бы объяснить любые наблюдения, которые мы могли бы теоретически сделать, но при этом оказывается совместимой с теми наблюдениями, которые мы фактически получаем.
Что именно составляет адекватное понятие сложности модели, — вопрос непростой. Как правило, модели с большим количеством параметров способны подгоняться под большее число произвольно назначенных меток. Однако это не всегда верно. Например, методы на основе ядра работают в пространствах с бесконечным числом параметров, но их сложность контролируется другими способами (Schölkopf and Smola, 2002). Одним из полезных понятий сложности является диапазон значений, которые могут принимать параметры. В этом смысле модель, чьи параметры могут принимать произвольные значения, считается более сложной. Мы вернёмся к этой идее в следующем разделе, когда введём затухание весов — ваш первый практический метод регуляризации. Примечательно, что сравнение сложности между представителями существенно разных классов моделей (например, деревьев решений и нейронных сетей) может быть затруднительным.
На этом этапе мы должны подчеркнуть ещё один важный момент, к которому мы вернемся при введении глубоких нейронных сетей. Когда модель способна подгоняться под произвольные метки, низкая ошибка на обучающей выборке не обязательно означает низкую ошибку обобщения. Однако это также не обязательно означает высокую ошибку обобщения! Все, что мы можем утверждать с уверенностью, заключается в том, что одной лишь низкой ошибки на обучающей выборке недостаточно для подтверждения низкой ошибки обобщения. Глубокие нейронные сети оказываются именно такими моделями: хотя на практике они демонстрируют хорошую обобщающую способность, они слишком мощны, чтобы делать какие-либо выводы, основываясь исключительно на ошибке обучения. В таких случаях нам приходится в большей степени полагаться на отложенные данные, чтобы подтвердить обобщающую способность постфактум. Ошибка на отложенных данных, то есть на валидационной выборке, называется ошибкой валидации.
3.6.2. Недообучение или переобучение?
Сравнивая ошибки на обучающей и валидационной выборках, следует учитывать две распространённые ситуации. Во-первых, нужно обращать внимание на случаи, когда ошибки на обучающей и валидационной выборках велики, но разрыв между ними незначителен. Если модель не способна уменьшить ошибку на обучающей выборке, это может означать, что модель слишком проста (т. е. недостаточно выразительна), чтобы уловить закономерность, которую мы пытаемся смоделировать. Кроме того, поскольку разрыв обобщающей способности (\(R_\textrm{emp} - R\)) между ошибками на обучающей и валидационной выборках мал, у нас есть основания полагать, что можно использовать более сложную модель. Это явление известно как недообучение.
С другой стороны, как мы обсуждали выше, следует обращать внимание на случаи, когда ошибка обучения значительно ниже ошибки валидации, что указывает на сильное переобучение. Обратите внимание, что переобучение не всегда плохо. В глубоком обучении, в частности, лучшие предиктивные модели часто показывают гораздо более высокие результаты на обучающих данных, чем на отложенных. В конечном счете, нас обычно интересует снижение обобщающей ошибки, а разрыв между ошибками важен лишь постольку, поскольку он становится препятствием на этом пути. Обратите внимание, что если ошибка обучения равна нулю, то обобщающий разрыв в точности равен обобщающей ошибке, и мы можем добиться прогресса, только уменьшая этот разрыв.
3.6.2.1. Подгонка полиномиальной кривой
Чтобы проиллюстрировать некоторые классические представления о переобучении и сложности модели, рассмотрим следующий пример: имея обучающие данные, состоящие из одного признака \(x\) и соответствующей вещественной метки \(y\), мы пытаемся найти полином степени \(d\)
для оценки метки \(y\). Это задача линейной регрессии, в которой признаки задаются степенями \(x\), веса модели определяются как \(w_i\), а смещение равно \(w_0\), поскольку \(x^0 = 1\) для всех \(x\). Поскольку это задача линейной регрессии, мы можем использовать квадратичную ошибку в качестве функции потерь.
Функция полинома более высокого порядка сложнее, чем функция полинома более низкого порядка, поскольку полином более высокого порядка содержит больше параметров, а диапазон выбора функции модели шире. При фиксированном наборе данных полиномиальные функции более высокого порядка всегда обеспечивают меньшую (в худшем случае равную) ошибку на обучающей выборке по сравнению с полиномами более низкого порядка. На самом деле, если каждый пример данных имеет уникальное значение \(x\), полиномиальная функция степени, равной количеству примеров данных, может идеально подогнать модель к обучающей выборке. В Fig. 3.6.1 мы сравниваем взаимосвязь между степенью полинома (сложностью модели) и недообучением, а также переобучением.
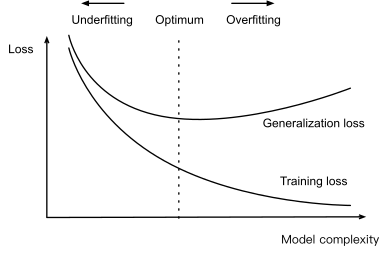
Fig. 3.6.1 Влияние сложности модели на недообучение и переобучение.
3.6.2.2. Размер набора данных
Как уже показывает приведённая выше оценка, ещё одним важным аспектом, который следует учитывать, является размер набора данных. При фиксированной модели чем меньше образцов содержится в обучающем наборе данных, тем выше вероятность (и тем сильнее выраженность) переобучения. По мере увеличения объёма обучающих данных ошибка обобщения, как правило, снижается. Более того, в общем случае наличие большего количества данных никогда не бывает лишним. Для фиксированной задачи и распределения данных сложность модели не должна расти быстрее, чем объём данных. При наличии большего количества данных мы можем попытаться подобрать более сложную модель. При недостатке данных более простые модели может быть сложнее превзойти. Для многих задач глубокое обучение превосходит линейные модели лишь тогда, когда доступно множество тысяч обучающих примеров. Частично нынешний успех глубокого обучения во многом обязан обилию массивных наборов данных, возникающих благодаря интернет-компаниям, дешевым системам хранения, подключенным устройствам и широкой цифровизации экономики.
3.6.3. Выбор модели
Обычно мы выбираем итоговую модель только после оценки нескольких моделей, различающихся по разным параметрам (архитектура, цели обучения, выбранные признаки, предобработка данных, скорости обучения и т. д.). Выбор среди множества моделей справедливо называется выбором модели.
В принципе, тестовую выборку не следует использовать до тех пор, пока не будут выбраны все гиперпараметры. Если применять данные тестовой выборки в процессе выбора модели, существует риск переобучения на этих данных. Тогда мы окажемся в серьезной беде. Если мы переобучим модель на обучающих данных, нас всегда будет сдерживать оценка на тестовой выборке. Но если мы переобучимся на тестовой выборке, как мы вообще узнаем об этом? Пример того, как это может привести к абсурдным результатам даже для моделей, сложность которых можно строго контролировать, см. в Ong et al. (2005).
Таким образом, мы никогда не должны полагаться на тестовые данные для выбора модели. Однако мы не можем полагаться исключительно на обучающие данные для выбора модели, поскольку не можем оценить обобщающую ошибку на тех же данных, которые используются для обучения модели.
В реальных сценариях картина усложняется. В идеале мы должны обращаться к тестовой выборке лишь один раз, чтобы оценить лучшую модель или сравнить небольшое количество моделей между собой, однако на практике тестовые данные редко выбрасываются после первого использования. Мы редко можем позволить себе новую тестовую выборку для каждого раунда экспериментов. Более того, многократное использование бенчмарк-данных на протяжении десятилетий может существенно повлиять на развитие алгоритмов, например, в задачах классификации изображений и оптического распознавания символов.
Общепринятой практикой решения проблемы обучения на тестовой выборке является разделение данных на три части, включающее валидационную выборку помимо обучающей и тестовой. В результате возникает запутанная ситуация, в которой границы между валидационными и тестовыми данными оказываются тревожно размытыми. Если не указано иное, в экспериментах этой книги мы фактически работаем с тем, что справедливо называть обучающими и валидационными данными, не имея настоящих тестовых выборок. Следовательно, точность, приводимая в каждом эксперименте книги, является валидационной точностью, а не истинной точностью на тестовой выборке.
3.6.3.1. Кросс-валидация
Когда обучающих данных недостаточно, мы можем даже не позволить себе выделить часть данных для формирования полноценной валидационной выборки. Одним из популярных решений этой проблемы является использование \(K\)-k-кратной перекрёстной проверки. В этом случае исходные обучающие данные разбиваются на \(K\) непересекающихся подмножеств. Затем процесс обучения и валидации выполняется \(K\) раз, каждый раз обучая модель на \(K-1\) подмножествах и валидируя её на другом подмножестве (том, которое не использовалось для обучения на данном этапе). Наконец, ошибки обучения и валидации оцениваются путём усреднения результатов по всем \(K\) экспериментам.
3.6.4. Резюме
В этом разделе мы рассмотрели некоторые основы обобщающей способности в машинном обучении. При переходе к глубоким моделям некоторые из этих идей становятся сложными и контринтуитивными: такие модели способны сильно переобучаться на данных, а соответствующие понятия сложности могут быть как неявными, так и контринтуитивными (например, более крупные архитектуры с большим числом параметров демонстрируют лучшую обобщающую способность). Мы оставляем вам несколько эмпирических правил:
Используйте наборы для валидации (или \(K\)-кратную перекрёстную проверку) для выбора модели;
Более сложные модели часто требуют больше данных;
Соответствующие понятия сложности включают как количество параметров, так и диапазон значений, которые они могут принимать;
При прочих равных условиях увеличение объёма данных почти всегда приводит к улучшению обобщающей способности;
Весь этот разговор об обобщающей способности основан на предположении о независимости и одинаковой распределённости (IID). Если ослабить это предположение, допустив сдвиг распределений между периодами обучения и тестирования, то без введения дополнительного (возможно, более мягкого) предположения мы не сможем ничего утверждать об обобщающей способности.
3.6.5. Упражнения
Когда можно точно решить задачу полиномиальной регрессии?
Приведите не менее пяти примеров, в которых зависимость случайных величин делает нецелесообразным рассмотрение данных как независимых и одинаково распределённых (IID).
Можно ли когда-либо ожидать нулевой ошибки обучения? При каких обстоятельствах можно ожидать нулевой ошибки обобщающей способности?
Почему \(K\)-кратная перекрёстная проверка требует таких больших вычислительных затрат?
Почему оценка ошибки \(K\)-кратной перекрёстной проверки является смещённой?
Размерность ВК определяется как максимальное количество точек, которые могут быть размечены произвольными метками \(\{\pm 1\}\) с помощью функции из некоторого класса функций. Почему это может быть не лучшим способом измерения сложности класса функций? Подсказка: рассмотрите значения функций.
Ваш руководитель поручает вам работу со сложным набором данных, на котором ваш текущий алгоритм работает не очень хорошо. Как бы вы обосновали перед ним необходимость получения большего количества данных? Подсказка: вы не можете увеличить объём данных, но можете его уменьшить.