
14.8. Региональные свёрточные нейронные сети (R-CNN)
Помимо одноэтапного обнаружения с несколькими боксами, описанного в Section 14.7, региональные свёрточные нейронные сети (R-CNN) также относятся к числу пионерских подходов применения глубокого обучения к задаче обнаружения объектов (Girshick et al., 2014). В этом разделе мы рассмотрим R-CNN и его последовательные улучшения: Fast R-CNN (Girshick, 2015), Faster R-CNN (Ren et al., 2015) и Mask R-CNN (He et al., 2017). Из-за ограниченности пространства мы сосредоточимся исключительно на архитектуре этих моделей.
14.8.1. R-CNN
Модель R-CNN сначала извлекает множество (например, 2000) предложений регионов из входного изображения (например, якорные рамки также можно рассматривать как предложения регионов), определяя их классы и ограничивающие рамки (например, смещения). (Girshick et al., 2014) Затем свёрточная нейронная сеть используется для выполнения прямого распространения на каждом предложении региона, чтобы извлечь его признаки. Далее признаки каждого предложения региона используются для предсказания класса и ограничивающей рамки этого региона.
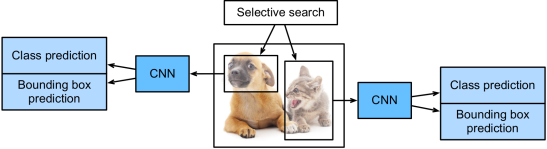
Fig. 14.8.1 Модель R-CNN.
Fig. 14.8.1 демонстрирует модель R-CNN. Более подробно R-CNN включает следующие четыре этапа:
Выполните селективный поиск для извлечения множества высококачественных предложений регионов на входном изображении (Uijlings et al., 2013). Эти предлагаемые регионы обычно выбираются на нескольких масштабах и имеют различные формы и размеры. Каждое предложение региона будет помечено классом и истинной ограничивающей рамкой.
Выберите предварительно обученную свёрточную нейронную сеть и усеките её перед выходным слоем. Измените размер каждого предложенного региона до размера, требуемого сетью, и получите извлечённые признаки для этого региона с помощью прямого распространения.
Рассмотрим извлеченные признаки и помеченный класс каждого предложения области в качестве примера. Обучим несколько опорно-векторных машин для классификации объектов, где каждая опорно-векторная машина определяет, содержит ли пример конкретный класс.
Возьмем извлеченные признаки и размеченную ограничивающую рамку каждого предложения области в качестве примера. Обучим модель линейной регрессии для предсказания истинной ограничивающей рамки.
Хотя модель R-CNN использует предварительно обученные свёрточные нейронные сети для эффективного извлечения признаков изображений, она работает медленно. Представьте, что мы выбираем тысячи регионов-предложений из одного входного изображения: для выполнения обнаружения объектов потребуется тысячи прямых проходов через свёрточную нейронную сеть. Такая огромная вычислительная нагрузка делает широкое применение R-CNN в реальных приложениях нецелесообразным.
14.8.2. Fast R-CNN
Главная проблема производительности R-CNN заключается в независимом прямом распространении через свёрточную нейронную сеть для каждого предложенного региона без разделения вычислений. Поскольку эти регионы обычно перекрываются, независимое извлечение признаков приводит к значительному повторению вычислений. Одним из ключевых улучшений fast R-CNN по сравнению с R-CNN является то, что прямое распространение через свёрточную нейронную сеть выполняется только для всего изображения (Girshick, 2015).
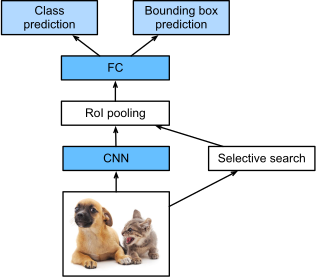
Fig. 14.8.2 Модель Fast R-CNN.
Fig. 14.8.2 описывает модель Fast R-CNN. Её основные вычисления заключаются в следующем:
В отличие от R-CNN, в Fast R-CNN входом CNN для извлечения признаков является всё изображение целиком, а не отдельные предложения регионов. Кроме того, эта CNN является обучаемой. Пусть при заданном входном изображении форма выхода CNN равна \(1 \times c \times h_1 \times w_1\).
Предположим, что алгоритм selective search генерирует \(n\) предложений регионов. Эти предложения регионов (различной формы) выделяют области интереса (различной формы) на выходе свёрточной нейронной сети. Затем из этих областей интереса извлекаются признаки одинаковой формы (например, заданы высота \(h_2\) и ширина \(w_2\)), чтобы их можно было легко объединить. Для этого в Fast R-CNN вводится слой пулинга области интереса (RoI pooling): на вход этого слоя подаются выход свёрточной нейронной сети и предложения регионов, а на выходе получаются объединённые признаки формы \(n \times c \times h_2 \times w_2\), которые извлекаются для всех предложений регионов.
С помощью полносвязного слоя преобразуем объединённые признаки в выходной тензор формы \(n \times d\), где \(d\) зависит от архитектуры модели.
Предсказываем класс и ограничивающую рамку для каждого из \(n\) предложенных регионов. Более конкретно, при предсказании класса и ограничивающей рамки преобразуем выход полносвязного слоя в выход формы \(n \times q\) (\(q\) — число классов) и в выход формы \(n \times 4\) соответственно. Для предсказания класса используется софтмакс-регрессия.
Слой пулинга областей интереса (region of interest pooling), предложенный в Fast R-CNN, отличается от слоя пулинга, рассмотренного в Section 7.5. В обычном слое пулинга мы косвенно управляем выходной формой, задавая размеры окна пулинга, дополнения и шага. В то же время в слое пулинга областей интереса мы можем напрямую задавать выходную форму.
Например, зададим высоту и ширину выхода для каждой области как \(h_2\) и \(w_2\) соответственно. Для любого окна интересующей области формы \(h \times w\) это окно делится на сетку из \(h_2 \times w_2\) подокон, где форма каждого подокна приблизительно равна \((h/h_2) \times (w/w_2)\). На практике высоту и ширину любого подокна следует округлять вверх, а в качестве выхода подокна используется наибольший элемент. Таким образом, слой пулинга интересующих областей может извлекать признаки одинаковой формы, даже если интересующие области имеют разные формы.
В качестве наглядного примера на рисунке Fig. 14.8.3 на входе \(4 \times 4\) выбирается верхняя левая \(3\times 3\) область интереса. Для этой области интереса с помощью слоя пулинга областей интереса \(2\times 2\) мы получаем выходной сигнал \(2\times 2\). Обратите внимание, что каждый из четырёх разделённых подокон содержит элементы 0, 1, 4 и 5 (5 — максимальное значение); 2 и 6 (6 — максимальное значение); 8 и 9 (9 — максимальное значение); и 10.
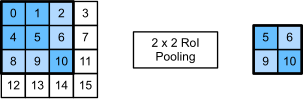
Fig. 14.8.3 Слой \(2\times 2\) пулинга области интереса.
Ниже мы продемонстрируем вычисления в слое пулинга области интереса.
Предположим, что высота и ширина признаков, извлеченных свёрточной
нейронной сетью X, равны 4, и имеется только один канал.
import torch
import torchvision

X = torch.arange(16.).reshape(1, 1, 4, 4)
X
Далее предположим, что высота и ширина входного изображения составляют 40 пикселей, а алгоритм selective search формирует два предложения регионов для этого изображения. Каждое предложение региона представлено пятью элементами: класс объекта, за которым следуют \((x, y)\)-координаты его верхнего левого и нижнего правого углов.
rois = torch.Tensor([[0, 0, 0, 20, 20], [0, 0, 10, 30, 30]])
Поскольку высота и ширина X составляют \(1/10\) от высоты и
ширины входного изображения, координаты двух предложений о регионах
умножаются на 0,1 в соответствии с указанным аргументом
spatial_scale. Затем два региона интереса отмечаются на X как
X[:, :, 0:3, 0:3] и X[:, :, 1:4, 0:4] соответственно. Наконец, в
пулинге регионов интереса \(2\times 2\) каждый регион интереса
делится на сетку подокон для дальнейшего извлечения признаков одинаковой
формы \(2\times 2\).
torchvision.ops.roi_pool(X, rois, output_size=(2, 2), spatial_scale=0.1)
14.8.3. Faster R-CNN
Чтобы повысить точность обнаружения объектов, модель Fast R-CNN обычно генерирует множество регионов-кандидатов с помощью алгоритма Selective Search. Чтобы сократить количество регионов-кандидатов без потери точности, Faster R-CNN предлагает заменить Selective Search на сеть предложений регионов (Ren et al., 2015).
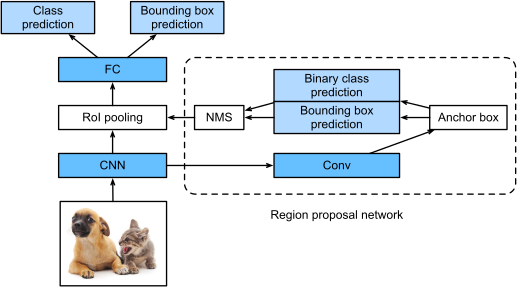
Fig. 14.8.4 Модель Faster R-CNN.
Fig. 14.8.4 показывает модель Faster R-CNN. В отличие от Fast R-CNN, Faster R-CNN изменяет только метод генерации регионов, заменяя селективный поиск на сеть генерации регионов. Остальная часть модели остается без изменений. Сеть генерации регионов работает следующим образом:
Используем свёрточный слой \(3\times 3\) с дополнением 1, чтобы преобразовать выход CNN в новый выход с \(c\) каналами. Таким образом, каждый элемент вдоль пространственных размерностей карт признаков, извлечённых CNN, получает новый вектор признаков длины \(c\).
Вокруг каждого пикселя карт признаков генерируются несколько якорных боксов различных масштабов и соотношений сторон, которым присваиваются метки.
Используя вектор признаков длины \(c\) в центре каждой якорной рамки, предсказываем бинарный класс (фон или объекты) и ограничивающую рамку для этой якорной рамки.
Рассмотрим предсказанные ограничивающие рамки, классы которых определены как объекты. Удалите перекрывающиеся результаты с помощью подавления немаксимумов. Оставшиеся предсказанные ограничивающие рамки для объектов являются предложениями регионов, необходимыми для слоя пулинга интересующей области.
Стоит отметить, что в рамках модели Faster R-CNN сеть предложений регионов (region proposal network) обучается совместно с остальной частью модели. Иными словами, целевая функция Faster R-CNN включает не только предсказание классов и ограничивающих рамок для задачи обнаружения объектов, но и предсказание бинарного класса и ограничивающих рамок для якорных рамок в сети предложений регионов. В результате сквозного обучения (end-to-end training) сеть предложений регионов учится генерировать высококачественные предложения регионов, что позволяет сохранять высокую точность обнаружения объектов при меньшем количестве предложений регионов, полученных в ходе обучения на данных.
14.8.4. Mask R-CNN
В обучающем наборе данных, если на изображениях также размечены позиционные метки объектов на уровне пикселей, Mask R-CNN может эффективно использовать такие детальные метки для дальнейшего повышения точности обнаружения объектов (He et al., 2017).
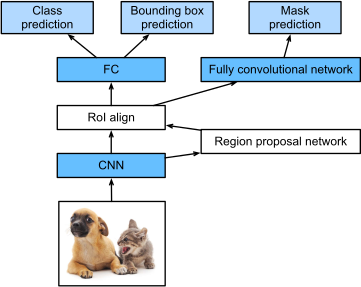
Fig. 14.8.5 Модель Mask R-CNN.
Как показано на рисунке Fig. 14.8.5, архитектура Mask R-CNN модифицирована на базе Faster R-CNN. В частности, в Mask R-CNN слой пулинга для области интереса заменен на слой выравнивания области интереса (RoI alignment). Данный слой использует билинейную интерполяцию для сохранения пространственной информации на картах признаков, что более подходит для предсказания на уровне пикселей. Выходные данные этого слоя представляют собой карты признаков одинаковой формы для всех областей интереса. Они используются не только для предсказания класса и ограничивающей рамки для каждой области интереса, но и для определения положения объекта на уровне пикселей с помощью дополнительной полностью свёрточной сети. Более подробная информация о применении полностью свёрточной сети для предсказания семантики изображения на уровне пикселей будет приведена в последующих разделах этой главы.
14.8.5. Резюме
R-CNN извлекает множество предложений регионов из входного изображения, использует свёрточную нейронную сеть для прямого распространения на каждом предложении региона с целью извлечения его признаков, а затем использует эти признаки для предсказания класса и ограничивающей рамки данного предложения региона.
Одним из ключевых улучшений Fast R-CNN по сравнению с R-CNN является то, что прямое распространение в CNN выполняется только для всего изображения. Также вводится слой пулинга для областей интереса, что позволяет извлекать признаки одинаковой формы для областей интереса различных форм.
В Faster R-CNN селективный поиск, использовавшийся в Fast R-CNN, заменён совместно обучаемой сетью генерации регионов, благодаря чему модель сохраняет высокую точность обнаружения объектов при меньшем количестве предлагаемых регионов.
На базе Faster R-CNN модель Mask R-CNN дополнительно вводит полностью свёрточную сеть, чтобы использовать пиксельные метки для дальнейшего повышения точности обнаружения объектов.
14.8.6. Упражнения
Можно ли сформулировать задачу обнаружения объектов как единую задачу регрессии, например, предсказывая ограничивающие рамки и вероятности классов? См. архитектуру модели YOLO (Redmon et al., 2016).
Сравните одноэтапное обнаружение множественных объектов (SSD) с методами, рассмотренными в этом разделе. Каковы их основные различия? См. рисунок 2 в Zhao et al. (2019).