
8.8. Проектирование архитектур свёрточных сетей
В предыдущих разделах мы совершили обзор современных подходов к проектированию сетей для компьютерного зрения. Общей чертой всех рассмотренных нами работ является их сильная зависимость от интуиции ученых. Многие архитектуры во многом обусловлены человеческим творчеством и лишь в меньшей степени — систематическим исследованием пространства параметров, которое предлагают глубокие сети. Тем не менее, этот подход проектирования сетей оказался чрезвычайно успешным.
С тех пор как AlexNet (Section 8.1) превзошёл традиционные модели компьютерного зрения на ImageNet, стало популярным конструировать очень глубокие сети путём последовательного объединения блоков свёрток, спроектированных по одному и тому же шаблону. В частности, \(3 \times 3\) свёртки получили широкое распространение благодаря сетям VGG (Section 8.2). NiN (Section 8.3) показал, что даже \(1 \times 1\) свёрток могут быть полезными за счёт добавления локальных нелинейностей. Кроме того, NiN решил проблему агрегации информации на выходе сети, осуществляя агрегацию по всем пространственным локациям. GoogLeNet (Section 8.4) добавил несколько ветвей с различной шириной свёрток, объединив преимущества VGG и NiN в блоке Inception. ResNets (Section 8.6) изменили индуктивное смещение в сторону отображения тождества (из \(f(x) = 0\)). Это позволило создавать очень глубокие сети. Почти через десятилетие архитектура ResNet остаётся популярной, что является свидетельством её качества. Наконец, ResNeXt (Section 8.6.5) добавил групповые свёртки, предложив лучший компромисс между количеством параметров и вычислительной сложностью. Предшественник трансформеров для компьютерного зрения, сети Squeeze-and-Excitation (SENets), обеспечивают эффективную передачу информации между локациями (Hu et al., 2018). Это достигается за счёт вычисления глобальной функции внимания для каждого канала.
До сих пор мы не рассматривали сети, полученные с помощью поиска нейронной архитектуры (NAS) (Liu et al., 2018, Zoph and Le, 2016). Мы решили опустить их, поскольку их стоимость обычно крайне высока: они опираются на грубый перебор, генетические алгоритмы, обучение с подкреплением или иные формы оптимизации гиперпараметров. При заданном фиксированном пространстве поиска NAS использует стратегию поиска для автоматического выбора архитектуры на основе полученной оценки производительности. Результатом NAS является один конкретный объект сети. Ярким примером такого результата являются EfficientNets (Tan and Le, 2019).
В дальнейшем мы обсудим идею, существенно отличающуюся от поиска единственной лучшей сети. Она вычислительно относительно недорога, позволяет получить научные инсайты в процессе работы и демонстрирует высокую эффективность с точки зрения качества результатов. Рассмотрим стратегию Radosavovic et al. (2020) по проектированию пространств сетей. Эта стратегия объединяет сильные стороны ручного проектирования и NAS. Она достигается за счет работы с распределениями сетей и оптимизации этих распределений таким образом, чтобы обеспечить высокую производительность для целых семейств сетей. Результатом стали RegNets, в частности RegNetX и RegNetY, а также ряд руководящих принципов для проектирования эффективных CNN.
import torch
from torch import nn
from torch.nn import functional as F
from d2l import torch as d2l
8.8.1. Пространство конструкций AnyNet
Описание ниже близко следует рассуждениям из Radosavovic et al. (2020) с некоторыми сокращениями, чтобы уложиться в рамки книги. Для начала нам нужен шаблон семейства сетей, которые мы будем исследовать. Одним из общих признаков архитектур, рассмотренных в этой главе, является то, что сети состоят из стебля (stem), тела (body) и головы (head). Стебель выполняет начальную обработку изображения, часто с помощью свёрток с большим размером ядра. Тело состоит из нескольких блоков, выполняющих основную часть преобразований, необходимых для перехода от исходных изображений к представлениям объектов. Наконец, голова преобразует эти данные в требуемые выходные значения, например, с помощью регрессора софтмакс для многоклассовой классификации. В свою очередь, тело состоит из нескольких стадий, работающих с изображением на убывающих разрешениях. На самом деле как стебель, так и каждая последующая стадия уменьшают пространственное разрешение в четыре раза. Наконец, каждая стадия состоит из одного или нескольких блоков. Эта структура характерна для всех сетей, от VGG до ResNeXt. Действительно, для проектирования универсальных сетей AnyNet Radosavovic et al. (2020) использовали блок ResNeXt из Fig. 8.6.5.
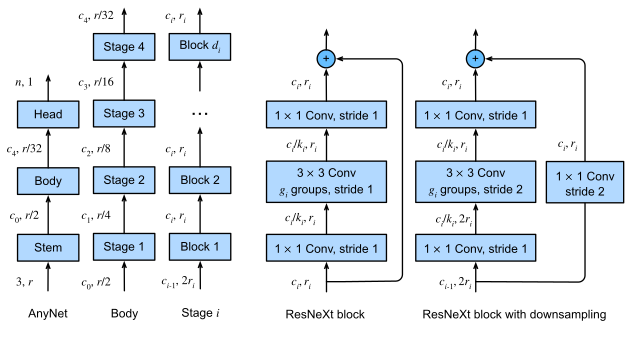
Fig. 8.8.1 Пространство вариантов AnyNet. Числа \((\mathit{c}, \mathit{r})\) вдоль каждой стрелки указывают на количество каналов \(c\) и разрешение \(\mathit{r} \times \mathit{r}\) изображений в данной точке. Слева направо: общая структура сети, состоящая из стебля, тела и головы; тело, состоящее из четырёх стадий; детальная структура стадии; две альтернативные структуры блоков, одна без уменьшения разрешения, а другая, уменьшающая разрешение в два раза по каждой размерности. Варианты дизайна включают глубину \(\mathit{d_i}\), количество выходных каналов \(\mathit{c_i}\), количество групп \(\mathit{g_i}\) и соотношение bottleneck \(\mathit{k_i}\) для любой стадии \(\mathit{i}\).
Рассмотрим подробно структуру, описанную в Fig. 8.8.1. Как упоминалось, AnyNet состоит из стебля, тела и головы. На вход стебля подаются RGB-изображения (3 канала), которые обрабатываются с помощью свёртки со \(3 \times 3\) каналами и шагом \(2\), за которой следует батч-нормализация, уменьшающая разрешение с \(r \times r\) до \(r/2 \times r/2\). Кроме того, он генерирует \(c_0\) каналов, которые служат входными данными для тела.
Поскольку сеть спроектирована для эффективной работы с изображениями ImageNet формы \(224 \times 224 \times 3\), её основная часть (body) уменьшает это значение до \(7 \times 7 \times c_4\) за счёт 4 стадий (напомним, что \(224 / 2^{1+4} = 7\)), каждая из которых имеет итоговый шаг \(2\). Наконец, головная часть (head) использует полностью стандартную конструкцию на основе глобального усредняющего пулинга, аналогичную NiN (Section 8.3), за которым следует полносвязный слой, формирующий вектор размерности \(n\) для классификации на \(n\) классов.
Большинство существенных проектных решений заложено в структуру самой сети. Она состоит из нескольких этапов, каждый из которых включает блоки ResNeXt одного типа, обсуждавшиеся в Section 8.6.5. Архитектура здесь полностью универсальна: мы начинаем с блока, который уменьшает разрешение в два раза за счёт использования шага \(2\) (правый блок на рисунке Fig. 8.8.1). Для согласования размеров ветвь остаточных связей в блоке ResNeXt должна проходить через свёртку с шагом \(1 \times 1\). За этим блоком следует переменное количество дополнительных блоков ResNeXt, которые не изменяют ни разрешение, ни число каналов. Обратите внимание, что распространённой практикой является добавление небольшого «бутылочного горлышка» в архитектуру блоков свёртки. Таким образом, при соотношении bottleneck \(k_i \geq 1\) мы выделяем определённое число каналов \(c_i/k_i\) для каждого блока этапа \(i\) (как показывают эксперименты, это не особенно эффективно, и такой подход следует исключить). Наконец, поскольку мы используем блоки ResNeXt, нам также необходимо выбрать число групп \(g_i\) для групповых свёрток на этапе \(i\).
Хотя это пространство дизайна кажется достаточно общим, оно тем не менее содержит множество параметров: мы можем задать ширину блока (число каналов) \(c_0, \ldots c_4\), глубину (число блоков) на каждом этапе \(d_1, \ldots d_4\), коэффициенты узкого места \(k_1, \ldots k_4\) и ширину групп (число групп) \(g_1, \ldots g_4\). В сумме это дает 17 параметров, что приводит к неоправданно большому числу конфигураций, требующих исследования. Нам нужны инструменты для эффективного сокращения этого огромного пространства поиска. Здесь проявляется концептуальная красота пространств дизайна. Прежде чем мы займемся этим, давайте сначала реализуем общий дизайн.
class AnyNet(d2l.Classifier):
    def stem(self, num_channels):
        return nn.Sequential(
            nn.LazyConv2d(num_channels, kernel_size=3, stride=2, padding=1),
            nn.LazyBatchNorm2d(), nn.ReLU())
Каждый этап состоит из depth блоков ResNeXt, где num_channels
определяет ширину блока. Обратите внимание, что первый блок уменьшает
высоту и ширину входных изображений вдвое.
@d2l.add_to_class(AnyNet)
def stage(self, depth, num_channels, groups, bot_mul):
    blk = []
    for i in range(depth):
        if i == 0:
            blk.append(d2l.ResNeXtBlock(num_channels, groups, bot_mul,
                use_1x1conv=True, strides=2))
        else:
            blk.append(d2l.ResNeXtBlock(num_channels, groups, bot_mul))
    return nn.Sequential(*blk)
Объединяя ствол, тело и голову сети, мы завершаем реализацию AnyNet.
@d2l.add_to_class(AnyNet)
def __init__(self, arch, stem_channels, lr=0.1, num_classes=10):
    super(AnyNet, self).__init__()
    self.save_hyperparameters()
    self.net = nn.Sequential(self.stem(stem_channels))
    for i, s in enumerate(arch):
        self.net.add_module(f'stage{i+1}', self.stage(*s))
    self.net.add_module('head', nn.Sequential(
        nn.AdaptiveAvgPool2d((1, 1)), nn.Flatten(),
        nn.LazyLinear(num_classes)))
    self.net.apply(d2l.init_cnn)
8.8.2. Распределения и параметры пространств параметров
Как уже обсуждалось в Section 8.8.1, параметры пространства проектирования являются гиперпараметрами сетей в этом пространстве. Рассмотрим задачу поиска хороших параметров в пространстве AnyNet. Мы могли бы попытаться найти единственный лучший выбор параметров для заданного объёма вычислений (например, количества операций с плавающей запятой и времени вычислений). Если бы мы допустили даже всего два возможных значения для каждого параметра, нам пришлось бы исследовать \(2^{17} = 131072\) комбинаций, чтобы найти лучшее решение. Это явно невыполнимо из-за чрезмерных затрат. Более того, из такого подхода мы практически не узнаем ничего о том, как следует проектировать сети. В следующий раз, когда мы добавим, скажем, X-стадию, операцию сдвига или что-то подобное, нам придется начинать с нуля. Ещё хуже то, что из-за стохастичности процесса обучения (округления, перемешивания, битовых ошибок) маловероятно, что два запуска дадут абсолютно одинаковые результаты. Более эффективная стратегия — попытаться определить общие правила, согласно которым должны соотноситься выборы параметров. Например, соотношение bottleneck-слоёв, количество каналов, блоков, групп или их изменение между слоями должно в идеале регулироваться набором простых правил. Подход, описанный в Radosavovic et al. (2019), опирается на следующие четыре предположения:
Мы предполагаем, что существуют общие принципы проектирования, благодаря которым многие сети, удовлетворяющие этим требованиям, демонстрируют высокую производительность. Следовательно, определение распределения по множеству сетей может быть разумной стратегией. Иными словами, мы исходим из того, что в стоге сена много хороших иголок.
Нам не обязательно доводить обучение сетей до сходимости, чтобы оценить их качество. Достаточно использовать промежуточные результаты в качестве надёжного ориентира для определения итоговой точности. Использование (приближенных) прокси-метрик для оптимизации целевой функции называется многоверностной оптимизацией (Forrester et al., 2007). Следовательно, оптимизация дизайна проводится на основе точности, достигнутой всего за несколько проходов по набору данных, что существенно снижает затраты.
Результаты, полученные в меньшем масштабе (для меньших сетей), обобщаются на более крупные. Следовательно, оптимизация проводится для сетей, структурно схожих с целевыми, но имеющих меньшее количество блоков, меньшее число каналов и т. д. Лишь в самом конце нам нужно будет убедиться, что найденные таким образом сети также демонстрируют хорошую производительность в полном масштабе.
Аспекты проектирования можно приблизительно разложить на независимые факторы, что позволяет оценивать их влияние на качество результата относительно независимо. Иными словами, задача оптимизации является умеренно простой.
Эти допущения позволяют нам дешево тестировать множество сетей. В частности, мы можем выбирать примеры равномерно из пространства конфигураций и оценивать их производительность. Затем мы можем оценить качество выбора параметров, проанализировав распределение ошибок/точности, достижимых с помощью указанных сетей. Обозначим через \(F(e)\) функцию распределения ошибок, совершаемых сетями заданного пространства дизайна, выбранными с использованием распределения вероятностей \(p\). То есть,
Наша цель — найти распределение \(p\) над сетями так, чтобы большинство сетей имело очень низкий уровень ошибок, а носитель распределения \(p\) был компактным. Разумеется, выполнить это точно вычислительно невозможно. Поэтому мы используем выборку сетей \(\mathcal{Z} \stackrel{\textrm{def}}{=} \{\textrm{net}_1, \ldots \textrm{net}_n\}\) (с ошибками \(e_1, \ldots, e_n\) соответственно) из \(p\) и применяем эмпирическую функцию распределения \(\hat{F}(e, \mathcal{Z})\) вместо неё:
Если кумулятивная функция распределения (CDF) одного набора вариантов доминирует (или совпадает) с CDF другого набора, это означает, что параметры первого набора предпочтительнее (или равнозначны). В связи с этим Radosavovic et al. (2020) экспериментировал с общим коэффициентом узкого места \(k_i = k\) для всех стадий \(i\) сети. Это устраняет три из четырёх параметров, управляющих коэффициентом узкого места. Чтобы оценить, влияет ли это ограничение на производительность (в отрицательную сторону), можно генерировать сети из ограниченного и неограниченного распределений и сравнивать соответствующие CDF. Оказалось, что это ограничение вообще не влияет на точность распределения сетей, что видно на первой панели Fig. 8.8.2. Аналогичным образом можно выбрать одинаковую ширину группы \(g_i = g\) для различных стадий сети. И снова это не влияет на производительность, как видно на второй панели Fig. 8.8.2. Совместное применение обоих шагов сокращает количество свободных параметров на шесть.
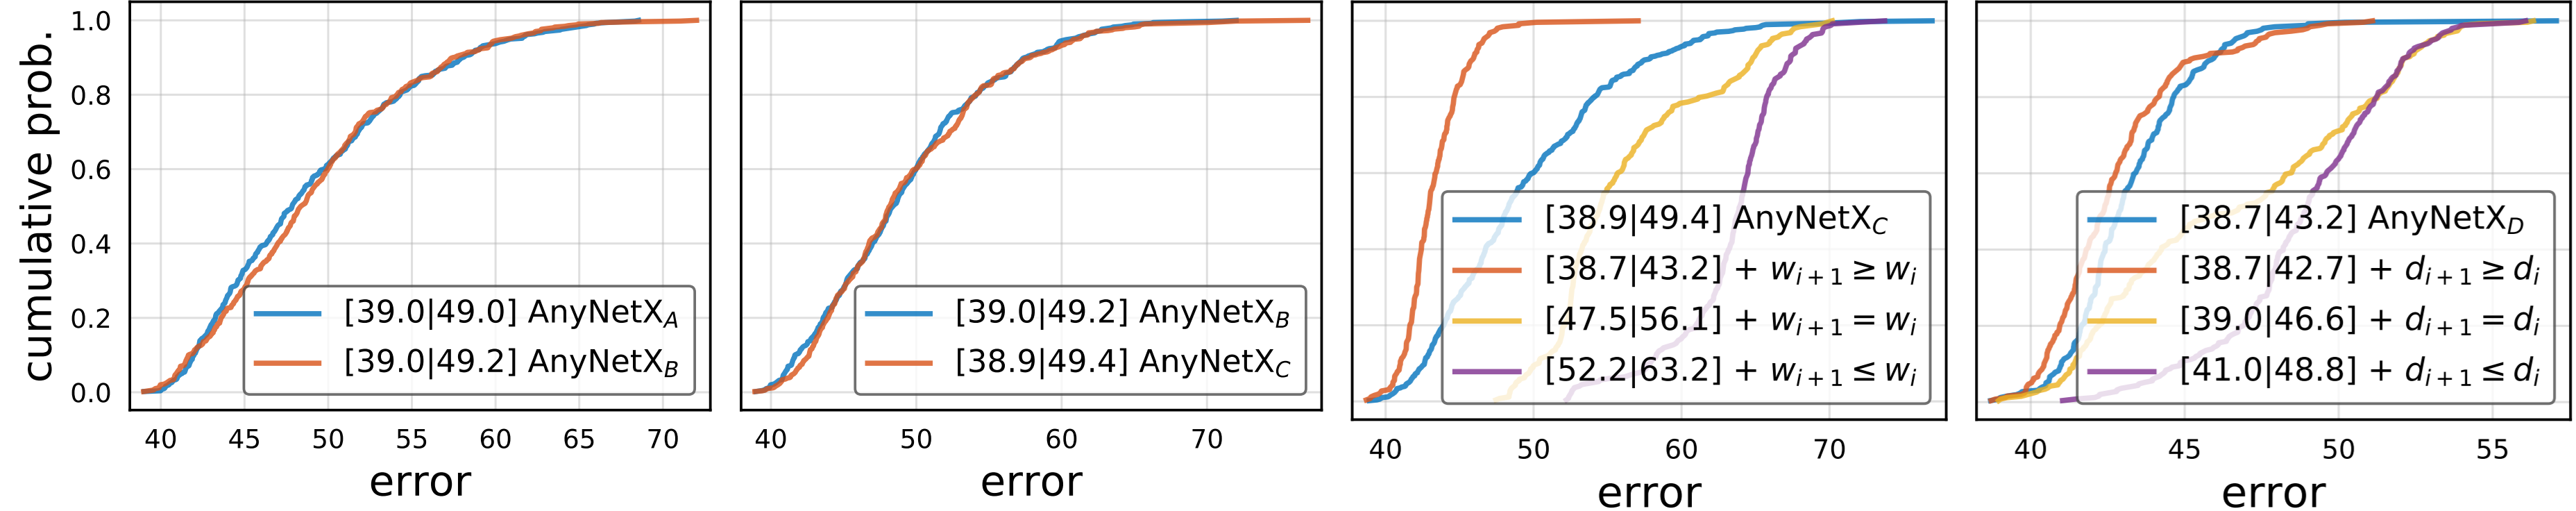
Fig. 8.8.2 Сравнение эмпирических функций распределения ошибок пространств дизайна. \(\textrm{AnyNet}_\mathit{A}\) — исходное пространство дизайна; \(\textrm{AnyNet}_\mathit{B}\) — фиксация коэффициентов узких мест (bottleneck ratios); \(\textrm{AnyNet}_\mathit{C}\) — фиксация ширины групп; \(\textrm{AnyNet}_\mathit{D}\) — увеличение глубины сети между этапами. Слева направо: (i) фиксация коэффициентов узких мест не влияет на производительность; (ii) фиксация ширины групп не влияет на производительность; (iii) увеличение ширины сети (числа каналов) между этапами улучшает производительность; (iv) увеличение глубины сети между этапами улучшает производительность. Рисунок предоставлен Radosavovic et al. (2020).
Далее мы рассмотрим способы сокращения множества возможных вариантов выбора ширины и глубины блоков. Разумно предположить, что по мере увеличения глубины число каналов должно возрастать, то есть \(c_i \geq c_{i-1}\) (\(w_{i+1} \geq w_i\) в их обозначениях из Fig. 8.8.2), что приводит к \(\textrm{AnyNetX}_D\). Аналогично, столь же разумно предположить, что по мере продвижения по блокам они должны становиться глубже, то есть \(d_i \geq d_{i-1}\), что приводит к \(\textrm{AnyNetX}_E\). Это можно экспериментально подтвердить на третьей и четвертой панелях рисунка Fig. 8.8.2 соответственно.
8.8.3. RegNet
Получившееся \(\textrm{AnyNetX}_E\) пространство проектирования состоит из простых сетей, следующих легко интерпретируемым принципам проектирования:
Использовать одно и то же соотношение для bottleneck-блоков \(k_i = k\) во всех стадиях \(i\);
Использовать одинаковую ширину группы \(g_i = g\) для всех стадий \(i\);
Увеличение ширины сети на этапах: \(c_{i} \leq c_{i+1}\);
Увеличение глубины сети на каждом этапе: \(d_{i} \leq d_{i+1}\).
Это оставляет нам окончательный набор решений: как выбрать конкретные значения для вышеуказанных параметров пространства дизайна \(\textrm{AnyNetX}_E\). Изучая наиболее эффективные сети из распределения, рассмотренного в \(\textrm{AnyNetX}_E\), можно заметить следующее: ширина сети должна линейно возрастать с увеличением индекса блока по всей сети, то есть \(c_j \approx c_0 + c_a j\), где \(j\) — индекс блока, а \(c_a > 0\) — наклон. Поскольку мы выбираем ширину блока только для каждого этапа, мы получаем кусочно-постоянную функцию, сконструированную для аппроксимации этой зависимости. Кроме того, эксперименты также показывают, что оптимальное соотношение bottleneck равно \(k = 1\), то есть рекомендуется вообще не использовать bottleneck-структуры.
Мы рекомендуем заинтересованным читателям ознакомиться с дополнительными подробностями в проектировании конкретных сетей для различных объёмов вычислений, изучив Radosavovic et al. (2020). Например, эффективный вариант RegNetX с 32 слоями задается параметрами \(k = 1\) (без бутылочного горлышка), \(g = 16\) (ширина группы равна 16), \(c_1 = 32\) и \(c_2 = 80\) (количество каналов для первого и второго этапа соответственно), выбранными глубинами в \(d_1=4\) и \(d_2=6\) блоков. Удивительный вывод из этого дизайна заключается в том, что он остается справедливым даже при исследовании сетей большего масштаба. Что ещё лучше, он также применим к архитектурам сетей Squeeze-and-Excitation (SE) (RegNetY), которые используют глобальную активацию каналов (Hu et al., 2018).
class RegNetX32(AnyNet):
    def __init__(self, lr=0.1, num_classes=10):
        stem_channels, groups, bot_mul = 32, 16, 1
        depths, channels = (4, 6), (32, 80)
        super().__init__(
            ((depths[0], channels[0], groups, bot_mul),
             (depths[1], channels[1], groups, bot_mul)),
            stem_channels, lr, num_classes)
Мы видим, что каждый этап RegNetX последовательно уменьшает разрешение и увеличивает количество выходных каналов.
RegNetX32().layer_summary((1, 1, 96, 96))
8.8.4. Обучение
Обучение 32-слойной RegNetX на наборе данных Fashion-MNIST происходит точно так же, как и раньше.
model = RegNetX32(lr=0.05)
trainer = d2l.Trainer(max_epochs=10, num_gpus=1)
data = d2l.FashionMNIST(batch_size=128, resize=(96, 96))
trainer.fit(model, data)
8.8.5. Обсуждение
Благодаря желательным индуктивным смещениям (предположениям или предпочтениям), таким как локальность и инвариантность к сдвигу (Section 7.1), в области компьютерного зрения свёрточные нейронные сети (CNN) долгое время оставались доминирующей архитектурой. Это положение сохранялось от LeNet вплоть до того момента, когда трансформеры (Section 11.7) (Dosovitskiy et al., 2021, Touvron et al., 2021) начали превосходить свёрточные сети по точности. Хотя многие недавние достижения в области трансформеров для зрения могут быть адаптированы и для свёрточных сетей (Liu et al., 2022), это возможно лишь при более высоких вычислительных затратах. Что не менее важно, недавние аппаратные оптимизации (NVIDIA Ampere и Hopper) лишь увеличили разрыв в пользу трансформеров.
Стоит отметить, что трансформеры обладают значительно меньшей степенью индуктивного смещения в отношении локальности и инвариантности к сдвигу, чем свёрточные нейронные сети. То, что изученные структуры оказались более эффективными, во многом обусловлено наличием крупных коллекций изображений, таких как LAION-400m и LAION-5B (Schuhmann et al., 2022), насчитывающих до 5 миллиардов изображений. Что ещё более удивительно, в этом контексте некоторые из наиболее релевантных работ даже включают многослойные персептроны (Tolstikhin et al., 2021).
Подводя итог, можно отметить, что визуальные трансформеры (Section 11.8) в настоящее время лидируют по показателям качества в задачах классификации изображений в больших масштабах, демонстрируя, что масштабируемость превосходит индуктивные смещения (Dosovitskiy et al., 2021). Сюда входит предобучение больших трансформеров (Section 11.9) с механизмом многоголового самовнимания (Section 11.5). Мы приглашаем читателей подробнее ознакомиться с этими главами.
8.8.6. Упражнения
Увеличьте количество стадий до четырёх. Можете ли вы спроектировать более глубокую сеть RegNetX, которая демонстрирует лучшие результаты?
Упростите RegNets, заменив блок ResNeXt на блок ResNet. Как изменилась производительность вашей новой модели?
Реализуйте несколько вариантов семейства «VioNet», нарушив принципы проектирования RegNetX. Как они работают? Какой из факторов (\(d_i\), \(c_i\), \(g_i\), \(b_i\)) является наиболее важным?
Ваша цель — спроектировать «идеальный» многослойный перцептрон (MLP). Можете ли вы использовать описанные выше принципы проектирования для поиска хороших архитектур? Возможно ли экстраполировать результаты от малых сетей к большим?