
10.3. Глубокие рекуррентные нейронные сети
До сих пор мы рассматривали сети, состоящие из входной последовательности, одного скрытого рекуррентного слоя и выходного слоя. Несмотря на то, что между входом на любом временном шаге и соответствующим выходом находится всего один скрытый слой, эти сети можно считать глубокими в определённом смысле. Входы с первого временного шага могут влиять на выходы на последнем временном шаге \(T\) (часто спустя сотни или тысячи шагов). Эти входы проходят через \(T\) применений рекуррентного слоя, прежде чем достигнуть финального выхода. Однако нам часто также необходимо сохранять возможность выражать сложные взаимосвязи между входами на данном временном шаге и выходами на том же самом шаге. Поэтому мы часто конструируем рекуррентные нейронные сети, которые являются глубокими не только во временном направлении, но и в направлении от входа к выходу. Это именно то понятие глубины, с которым мы уже встречались при разработке многослойных перцептронов и глубоких свёрточных нейронных сетей.
Стандартный метод построения таких глубоких RNN поразительно прост: мы размещаем RNN друг над другом. Учитывая последовательность длины \(T\), первый RNN генерирует последовательность значений, также длины \(T\). Эти значения, в свою очередь, служат входами для следующего слоя RNN. В этом коротком разделе мы продемонстрируем этот шаблон проектирования и приведём простой пример кода для реализации таких стекированных RNN. Ниже, в Fig. 10.3.1, мы иллюстрируем глубокую RNN с \(L\) скрытыми слоями. Каждое скрытое состояние обрабатывает входную последовательность и генерирует выходную последовательность. Более того, любая ячейка RNN (белый квадрат в Fig. 10.3.1) на каждом временном шаге зависит как от значения того же слоя на предыдущем временном шаге, так и от значения предыдущего слоя на том же временном шаге.
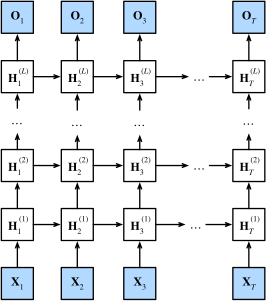
Fig. 10.3.1 Архитектура глубокой рекуррентной нейронной сети.
Формально предположим, что в момент времени \(t\) имеется входной мини-батч \(\mathbf{X}_t \in \mathbb{R}^{n \times d}\) (количество примеров \(=n\); количество входов в каждом примере \(=d\)). В тот же момент времени пусть скрытое состояние \(l^\textrm{th}\) скрытого слоя (\(l=1,\ldots,L\)) будет равно \(\mathbf{H}_t^{(l)} \in \mathbb{R}^{n \times h}\) (количество скрытых единиц \(=h\)), а переменная выходного слоя — \(\mathbf{O}_t \in \mathbb{R}^{n \times q}\) (количество выходов: \(q\)). При заданных параметрах \(\mathbf{H}_t^{(0)} = \mathbf{X}_t\) скрытое состояние \(l^\textrm{th}\) скрытого слоя, использующего функцию активации \(\phi_l\), вычисляется следующим образом:
где веса \(\mathbf{W}_{\textrm{xh}}^{(l)} \in \mathbb{R}^{h \times h}\) и \(\mathbf{W}_{\textrm{hh}}^{(l)} \in \mathbb{R}^{h \times h}\), а также смещение \(\mathbf{b}_\textrm{h}^{(l)} \in \mathbb{R}^{1 \times h}\), являются параметрами модели скрытого слоя \(l^\textrm{th}\).
В конце вычисление выходного слоя основано исключительно на скрытом состоянии последнего \(L^\textrm{th}\) скрытого слоя:
где вес \(\mathbf{W}_{\textrm{hq}} \in \mathbb{R}^{h \times q}\) и смещение \(\mathbf{b}_\textrm{q} \in \mathbb{R}^{1 \times q}\) — параметры модели выходного слоя.
Как и в случае с многослойными перцептронами, количество скрытых слоёв \(L\) и количество скрытых единиц \(h\) являются гиперпараметрами, которые можно настраивать. Типичная ширина слоёв RNN (\(h\)) находится в диапазоне \((64, 2056)\), а типичная глубина (\(L\)) — в диапазоне \((1, 8)\). Кроме того, мы можем легко получить глубокую вентильную RNN, заменив вычисление скрытого состояния в (10.3.1) на вычисление из LSTM или GRU.
import torch
from torch import nn
from d2l import torch as d2l
10.3.1. Реализация с нуля
Чтобы реализовать многослойный RNN с нуля, мы можем рассматривать каждый
слой как RNNScratch объект со своими обучаемыми параметрами.
class StackedRNNScratch(d2l.Module):
    def __init__(self, num_inputs, num_hiddens, num_layers, sigma=0.01):
        super().__init__()
        self.save_hyperparameters()
        self.rnns = nn.Sequential(*[d2l.RNNScratch(
            num_inputs if i==0 else num_hiddens, num_hiddens, sigma)
                                    for i in range(num_layers)])
Многослойное прямое вычисление просто выполняет прямое вычисление слой за слоем.
@d2l.add_to_class(StackedRNNScratch)
def forward(self, inputs, Hs=None):
    outputs = inputs
    if Hs is None: Hs = [None] * self.num_layers
    for i in range(self.num_layers):
        outputs, Hs[i] = self.rnns[i](outputs, Hs[i])
        outputs = torch.stack(outputs, 0)
    return outputs, Hs
В качестве примера мы обучим глубокую модель GRU на наборе данных The Time Machine (так же, как в Section 9.5). Для простоты мы установим количество слоёв равным 2.
data = d2l.TimeMachine(batch_size=1024, num_steps=32)
rnn_block = StackedRNNScratch(num_inputs=len(data.vocab),
                              num_hiddens=32, num_layers=2)
model = d2l.RNNLMScratch(rnn_block, vocab_size=len(data.vocab), lr=2)
trainer = d2l.Trainer(max_epochs=100, gradient_clip_val=1, num_gpus=1)
trainer.fit(model, data)
10.3.2. Краткая реализация
К счастью, многие организационные детали, необходимые для реализации многослойных RNN, уже доступны в высокоуровневых API. Наша лаконичная реализация будет использовать такие встроенные возможности. Код обобщает тот, который мы использовали ранее в Section 10.2, позволяя явно указывать количество слоёв, а не полагаться на значение по умолчанию — один слой.
class GRU(d2l.RNN):  #@save
    """The multilayer GRU model."""
    def __init__(self, num_inputs, num_hiddens, num_layers, dropout=0):
        d2l.Module.__init__(self)
        self.save_hyperparameters()
        self.rnn = nn.GRU(num_inputs, num_hiddens, num_layers,
                          dropout=dropout)
Решения об архитектуре, такие как выбор гиперпараметров, очень похожи на
те, что описаны в Section 10.2. Мы выбираем то же количество
входных и выходных данных, равное числу различных токенов, то есть
vocab_size. Количество скрытых нейронов по-прежнему равно 32.
Единственное отличие заключается в том, что теперь мы выбираем
нетривиальное количество скрытых слоёв, указывая значение
num_layers.
gru = GRU(num_inputs=len(data.vocab), num_hiddens=32, num_layers=2)
model = d2l.RNNLM(gru, vocab_size=len(data.vocab), lr=2)
trainer.fit(model, data)
model.predict('it has', 20, data.vocab, d2l.try_gpu())
10.3.3. Итоги
В глубоких рекуррентных нейронных сетях информация скрытого состояния передается на следующий временной шаг текущего слоя и на текущий временной шаг следующего слоя. Существует множество различных вариантов глубоких рекуррентных нейронных сетей, таких как LSTM, GRU или обычные RNN. Удобно то, что все эти модели доступны в виде компонентов высокоуровневых API фреймворков глубокого обучения. Инициализация моделей требует тщательного подхода. В целом, для обеспечения корректной сходимости глубоких рекуррентных нейронных сетей требуется значительная работа, например, настройка скорости обучения и применение градиентного клиппинга.
10.3.4. Упражнения
Замените GRU на LSTM и сравните точность и скорость обучения.
Увеличьте обучающие данные, включив в них несколько книг. Какое минимальное значение перплексии можно достичь?
Хотели бы вы объединять тексты разных авторов при моделировании текста? Почему это хорошая идея? Что может пойти не так?