
2.4. Математический анализ
Долгое время вопрос о том, как вычислить площадь круга, оставался загадкой. Затем в Древней Греции математик Архимед предложил гениальную идею вписать в круг последовательность многоугольников с возрастающим числом вершин (Fig. 2.4.1). Для многоугольника с \(n\) вершинами мы получаем \(n\) треугольников. Высота каждого треугольника стремится к радиусу \(r\) по мере того, как мы увеличиваем число разбиений круга. В то же время его основание стремится к \(2 \pi r/n\), поскольку отношение длины дуги к длине хорды стремится к 1 при большом числе вершин. Таким образом, площадь многоугольника стремится к \(n \cdot r \cdot \frac{1}{2} (2 \pi r/n) = \pi r^2\).
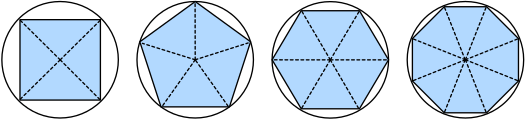
Fig. 2.4.1 Нахождение площади круга с помощью предельного процесса.
Этот предельный переход лежит в основе как дифференциального, так и интегрального исчисления. Первое из них позволяет понять, как изменить значение функции, манипулируя её аргументами. Это оказывается полезным при решении задач оптимизации, с которыми мы сталкиваемся в глубоком обучении, где мы многократно обновляем параметры, чтобы уменьшить функцию потерь. Оптимизация отвечает на вопрос, как наилучшим образом подогнать наши модели к обучающим данным, а исчисление является её ключевым предварительным условием. Однако не следует забывать, что наша конечная цель — хорошо работать с ранее невиданными данными. Эта проблема называется обобщающей способностью и станет одним из основных направлений рассмотрения в других главах.
%matplotlib inline
import numpy as np
from matplotlib_inline import backend_inline
from d2l import torch as d2l
2.4.1. Производные и дифференцирование
Проще говоря, производная — это скорость изменения функции при изменении её аргументов. Производные показывают, насколько быстро функция потерь увеличивалась бы или уменьшалась, если бы мы увеличили или уменьшили каждый параметр на бесконечно малую величину. Формально для функций \(f: \mathbb{R} \rightarrow \mathbb{R}\), отображающих скаляры в скаляры, производная \(f\) в точке \(x\) определяется как
Этот член в правой части называется пределом и показывает, что происходит со значением выражения, когда указанная переменная приближается к определённому значению. Этот предел указывает, к чему стремится отношение возмущения \(h\) к изменению значения функции \(f(x + h) - f(x)\) при стремлении его размера к нулю.
Когда \(f'(x)\) существует, \(f\) называют дифференцируемой в точке \(x\); а когда \(f'(x)\) существует для всех \(x\) из некоторого множества, например, интервала \([a,b]\), мы говорим, что \(f\) дифференцируема на этом множестве. Не все функции дифференцируемы, включая многие из тех, которые мы хотим оптимизировать, такие как точность и площадь под ROC-кривой (AUC). Однако, поскольку вычисление производной функции потерь является ключевым шагом почти во всех алгоритмах обучения глубоких нейронных сетей, мы часто оптимизируем вместо неё дифференцируемую суррогатную функцию.
Мы можем интерпретировать производную \(f'(x)\) как мгновенную скорость изменения \(f(x)\) по \(x\). Разберём интуитивное понимание на примере. Определим \(u = f(x) = 3x^2-4x\).
def f(x):
    return 3 * x ** 2 - 4 * x
Полагая \(x=1\), мы видим, что \(\frac{f(x+h) - f(x)}{h}\) стремится к \(2\) при стремлении \(h\) к \(0\). Хотя этот эксперимент не обладает строгостью математического доказательства, мы можем быстро убедиться, что действительно \(f'(1) = 2\).
for h in 10.0**np.arange(-1, -6, -1):
    print(f'h={h:.5f}, numerical limit={(f(1+h)-f(1))/h:.5f}')
Существует несколько эквивалентных нотаций для обозначения производных. Учитывая \(y = f(x)\), следующие выражения эквивалентны:
где символы \(\frac{d}{dx}\) и \(D\) — это операторы дифференцирования. Ниже приведены производные некоторых распространённых функций:
Функции, составленные из дифференцируемых функций, часто сами являются дифференцируемыми. Следующие правила оказываются полезными при работе с композициями любых дифференцируемых функций \(f\) и \(g\), а также констант \(C\).
Используя это, мы можем применить правила для нахождения производной \(3 x^2 - 4x\) через
Подстановка \(x = 1\) показывает, что производная действительно равна \(2\) в этой точке. Обратите внимание, что производные показывают наклон функции в конкретной точке.
2.4.2. Утилиты визуализации
Мы можем визуализировать градиенты функций с помощью библиотеки
matplotlib . Для этого нам нужно определить несколько функций. Как
следует из названия, use_svg_display указывает matplotlib
выводить графики в формате SVG для получения более чётких изображений.
Комментарий #@save — это специальный модификатор, который позволяет
сохранить любую функцию, класс или другой блок кода в пакете d2l,
чтобы вызывать их позже без повторения кода, например, через
d2l.use_svg_display().
def use_svg_display():  #@save
    """Use the svg format to display a plot in Jupyter."""
    backend_inline.set_matplotlib_formats('svg')
Кроме того, мы можем задавать размеры рисунков с помощью
set_figsize. Поскольку оператор импорта
from matplotlib import pyplot as plt был отмечен через #@save в
пакете d2l, мы можем вызывать d2l.plt.
def set_figsize(figsize=(3.5, 2.5)):  #@save
    """Set the figure size for matplotlib."""
    use_svg_display()
    d2l.plt.rcParams['figure.figsize'] = figsize
Функция set_axes позволяет связывать оси с различными свойствами,
включая метки, диапазоны и масштабы.
#@save
def set_axes(axes, xlabel, ylabel, xlim, ylim, xscale, yscale, legend):
    """Set the axes for matplotlib."""
    axes.set_xlabel(xlabel), axes.set_ylabel(ylabel)
    axes.set_xscale(xscale), axes.set_yscale(yscale)
    axes.set_xlim(xlim),     axes.set_ylim(ylim)
    if legend:
        axes.legend(legend)
    axes.grid()
С помощью этих трёх функций мы можем определить функцию plot для
наложения нескольких кривых. Значительная часть кода здесь предназначена
лишь для проверки соответствия размеров и форм входных данных.
#@save
def plot(X, Y=None, xlabel=None, ylabel=None, legend=[], xlim=None,
         ylim=None, xscale='linear', yscale='linear',
         fmts=('-', 'm--', 'g-.', 'r:'), figsize=(3.5, 2.5), axes=None):
    """Plot data points."""

    def has_one_axis(X):  # True if X (tensor or list) has 1 axis
        return (hasattr(X, "ndim") and X.ndim == 1 or isinstance(X, list)
                and not hasattr(X[0], "__len__"))

    if has_one_axis(X): X = [X]
    if Y is None:
        X, Y = [[]] * len(X), X
    elif has_one_axis(Y):
        Y = [Y]
    if len(X) != len(Y):
        X = X * len(Y)

    set_figsize(figsize)
    if axes is None:
        axes = d2l.plt.gca()
    axes.cla()
    for x, y, fmt in zip(X, Y, fmts):
        axes.plot(x,y,fmt) if len(x) else axes.plot(y,fmt)
    set_axes(axes, xlabel, ylabel, xlim, ylim, xscale, yscale, legend)
Теперь мы можем построить график функции \(u = f(x)\) и её касательной \(y = 2x - 3\) в точке \(x=1\), где коэффициент \(2\) — это угловой коэффициент касательной.
x = np.arange(0, 3, 0.1)
plot(x, [f(x), 2 * x - 3], 'x', 'f(x)', legend=['f(x)', 'Tangent line (x=1)'])
2.4.3. Частные производные и градиенты
До сих пор мы рассматривали дифференцирование функций одной переменной. В глубоком обучении нам также приходится работать с функциями многих переменных. Мы кратко введём понятия производной, применимые к таким многомерным функциям.
Пусть \(y = f(x_1, x_2, \ldots, x_n)\) — функция от \(n\) переменных. Частная производная \(y\) по параметру \(x_i\), являющемуся её \(i^\textrm{th}\) параметром, равна
Чтобы вычислить \(\frac{\partial y}{\partial x_i}\), мы можем рассматривать \(x_1, \ldots, x_{i-1}, x_{i+1}, \ldots, x_n\) как константы и найти производную \(y\) по \(x_i\). Следующие обозначения для частных производных являются общепринятыми и означают одно и то же:
Мы можем объединить частные производные многомерной функции по всем её переменным, чтобы получить вектор, называемый градиентом функции. Предположим, что входом функции \(f: \mathbb{R}^n \rightarrow \mathbb{R}\) является \(n\)-мерный вектор \(\mathbf{x} = [x_1, x_2, \ldots, x_n]^\top\), а выходом — скаляр. Градиент функции \(f\) по аргументу \(\mathbf{x}\) — это вектор из \(n\) частных производных:
Когда это не вызывает неоднозначности, \(\nabla_{\mathbf{x}} f(\mathbf{x})\) обычно заменяют на \(\nabla f(\mathbf{x})\). Следующие правила полезны при дифференцировании функций многих переменных:
Для всех \(\mathbf{A} \in \mathbb{R}^{m \times n}\) выполняются \(\nabla_{\mathbf{x}} \mathbf{A} \mathbf{x} = \mathbf{A}^\top\) и \(\nabla_{\mathbf{x}} \mathbf{x}^\top \mathbf{A} = \mathbf{A}\).
Для квадратных матриц \(\mathbf{A} \in \mathbb{R}^{n \times n}\) выполняется, что \(\nabla_{\mathbf{x}} \mathbf{x}^\top \mathbf{A} \mathbf{x} = (\mathbf{A} + \mathbf{A}^\top)\mathbf{x}\), и в частности \(\nabla_{\mathbf{x}} \|\mathbf{x} \|^2 = \nabla_{\mathbf{x}} \mathbf{x}^\top \mathbf{x} = 2\mathbf{x}\).
Аналогично, для любой матрицы \(\mathbf{X}\) выполняется равенство \(\nabla_{\mathbf{X}} \|\mathbf{X} \|_\textrm{F}^2 = 2\mathbf{X}\).
2.4.4. Цепное правило
В глубоком обучении вычисление градиентов часто затруднено, поскольку мы имеем дело с глубоко вложенными функциями (функциями от функций от функций…). К счастью, это решает цепное правило. Вернёмся к функциям одной переменной: предположим, что \(y = f(g(x))\), а базовые функции \(y=f(u)\) и \(u=g(x)\) дифференцируемы. Согласно цепному правилу,
Возвращаясь к функциям многих переменных, предположим, что \(y = f(\mathbf{u})\) зависит от переменных \(u_1, u_2, \ldots, u_m\), где каждая \(u_i = g_i(\mathbf{x})\) зависит от переменных \(x_1, x_2, \ldots, x_n\), т. е. \(\mathbf{u} = g(\mathbf{x})\). Тогда цепное правило гласит, что
где \(\mathbf{A} \in \mathbb{R}^{n \times m}\) — это матрица, содержащая производную вектора \(\mathbf{u}\) по вектору \(\mathbf{x}\). Таким образом, вычисление градиента требует вычисления произведения вектора на матрицу. Это одна из ключевых причин, по которым линейная алгебра является столь неотъемлемым компонентом при создании систем глубокого обучения.
2.4.5. Обсуждение
Хотя мы лишь поверхностно коснулись этой глубокой темы, ряд концепций уже становится ясным: во-первых, правила дифференцирования сложных функций можно применять регулярно, что позволяет вычислять градиенты автоматически. Эта задача не требует креативности, поэтому мы можем направить наши когнитивные ресурсы на другие цели. Во-вторых, вычисление производных вектор-функций требует умножения матриц при обходе графа зависимостей переменных от выхода ко входу. В частности, этот граф обходится в прямом направлении при вычислении функции и в обратном направлении при вычислении градиентов. В последующих главах мы формально введем обратное распространение ошибки — вычислительную процедуру для применения цепного правила.
С точки зрения оптимизации, градиенты позволяют определить, как изменить параметры модели, чтобы уменьшить функцию потерь, и каждый шаг алгоритмов оптимизации, рассматриваемых в этой книге, потребует вычисления градиента.
2.4.6. Упражнения
До сих пор мы принимали правила дифференцирования как само собой разумеющиеся. Используя определение производной и пределы, докажите свойства для (i) \(f(x) = c\), (ii) \(f(x) = x^n\), (iii) \(f(x) = e^x\) и (iv) \(f(x) = \log x\).
Аналогичным образом докажите правила дифференцирования произведения, суммы и частного, исходя из первых принципов.
Докажите, что правило умножения на константу является частным случаем правила произведения.
Вычислите производную \(f(x) = x^x\).
Что означает, что \(f'(x) = 0\) для некоторого \(x\)? Приведите пример функции \(f\) и точки \(x\), для которой это может выполняться.
Постройте график функции \(y = f(x) = x^3 - \frac{1}{x}\) и проведите касательную к ней в точке \(x = 1\).
Найдите градиент функции \(f(\mathbf{x}) = 3x_1^2 + 5e^{x_2}\).
Каков градиент функции \(f(\mathbf{x}) = \|\mathbf{x}\|_2\)? Что происходит для \(\mathbf{x} = \mathbf{0}\)?
Можете ли вы записать цепное правило для случая, когда \(u = f(x, y, z)\) и \(x = x(a, b)\), \(y = y(a, b)\) и \(z = z(a, b)\)?
Дана обратимая функция \(f(x)\). Вычислите производную её обратной функции \(f^{-1}(x)\). Здесь выполняется соотношение \(f^{-1}(f(x)) = x\), а обратно \(f(f^{-1}(y)) = y\). Подсказка: используйте эти свойства в выводе.