
8.2. Сети, использующие блоки (VGG)
Хотя AlexNet предоставил эмпирические доказательства того, что глубокие свёрточные нейронные сети могут достигать хороших результатов, он не предложил общий шаблон для руководства последующих исследователей при проектировании новых сетей. В следующих разделах мы рассмотрим несколько эвристических концепций, обычно используемых при разработке глубоких сетей.
Прогресс в этой области отражает прогресс в области VLSI (очень больших интегральных схем) при проектировании чипов, когда инженеры перешли от размещения транзисторов к логическим элементам, а затем — к логическим блокам (Mead, 1980). Аналогичным образом проектирование архитектур нейронных сетей становится всё более абстрактным: исследователи перешли от рассмотрения отдельных нейронов к целым слоям, а теперь — к блокам, то есть повторяющимся паттернам слоёв. Спустя десятилетие этот подход эволюционировал до использования целых обученных моделей для адаптации их к другим, хотя и связанным, задачам. Такие крупные предварительно обученные модели обычно называют фундаментальными моделями (Bommasani et al., 2021).
Возвращаясь к проектированию сетей. Идея использования блоков впервые появилась в группе визуальной геометрии (Visual Geometry Group) Оксфордского университета в их одноимённой сети VGG (Simonyan and Zisserman, 2014). Реализовать такие повторяющиеся структуры в коде с помощью любого современного фреймворка для глубокого обучения довольно просто, если использовать циклы и подпрограммы.
import torch
from torch import nn
from d2l import torch as d2l
8.2.1. Блоки VGG
Базовым строительным блоком свёрточных нейронных сетей является последовательность следующих элементов: (i) свёрточный слой с дополнением для сохранения разрешения, (ii) нелинейность, например ReLU, (iii) слой пулинга, например, пулинг с максимальным значением, для уменьшения разрешения. Одна из проблем такого подхода заключается в том, что пространственное разрешение уменьшается довольно быстро. В частности, это накладывает жёсткое ограничение на количество свёрточных слоёв \(\log_2 d\) в сети до того, как все размеры (\(d\)) будут исчерпаны. Например, в случае набора данных ImageNet таким образом невозможно создать сеть, содержащую более 8 свёрточных слоёв.
Ключевая идея Simonyan and Zisserman (2014) заключалась в использовании нескольких свёрток между этапами уменьшения разрешения с помощью максимального пулинга, объединённых в блок. Их главным вопросом было то, какие архитектуры показывают лучшую производительность: глубокие или широкие сети. Например, последовательное применение двух \(3 \times 3\) свёрток воздействует на те же пиксели, что и одна \(5 \times 5\) свёртка. В то же время последняя требует примерно столько же параметров (\(25 \cdot c^2\)), сколько и три \(3 \times 3\) свёртки (\(3 \cdot 9 \cdot c^2\)). В достаточно детальном анализе они показали, что глубокие и узкие сети значительно превосходят свои мелкие аналоги. Это стимулировало развитие глубокого обучения в направлении создания всё более глубоких сетей, где для типовых задач количество слоёв превышало 100. Использование нескольких \(3 \times 3\) свёрток стало золотым стандартом в последующих глубоких сетях (это архитектурное решение было пересмотрено лишь недавно в работе Liu et al. (2022)). В результате эффективные реализации малых свёрток стали неотъемлемой частью вычислений на графических процессорах (GPU) (Lavin and Gray, 2016).
Возвращаясь к VGG: блок VGG состоит из последовательности свёрток с
ядрами размера \(3\times3\) и дополнением 1 (сохраняющим высоту и
ширину), за которыми следует слой максимального пулинга
\(2 \times 2\) с шагом 2 (уменьшающим высоту и ширину вдвое после
каждого блока). В приведённом ниже коде мы определяем функцию
vgg_block для реализации одного блока VGG.
Функция ниже принимает два аргумента: количество свёрточных слоёв
num_convs и число выходных каналов num_channels.
def vgg_block(num_convs, out_channels):
    layers = []
    for _ in range(num_convs):
        layers.append(nn.LazyConv2d(out_channels, kernel_size=3, padding=1))
        layers.append(nn.ReLU())
    layers.append(nn.MaxPool2d(kernel_size=2,stride=2))
    return nn.Sequential(*layers)
8.2.2. Сеть VGG
Как и AlexNet и LeNet, сеть VGG можно разделить на две части: первая состоит преимущественно из свёрточных и пулинг-слоёв, а вторая — из полносвязных слоёв, аналогичных тем, что используются в AlexNet. Ключевое отличие заключается в том, что свёрточные слои сгруппированы в нелинейные преобразования, не изменяющие размерность, за которыми следует шаг уменьшения разрешения, как показано на рисунке Fig. 8.2.1.
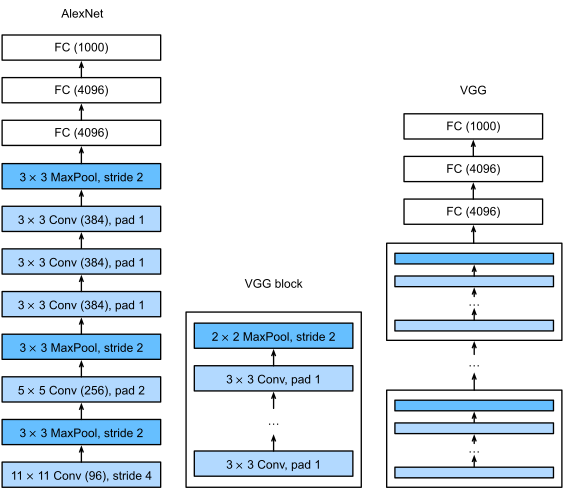
Fig. 8.2.1 От AlexNet к VGG. Ключевое отличие заключается в том, что VGG состоит из блоков слоёв, тогда как слои AlexNet проектировались индивидуально.
Свёрточная часть сети последовательно соединяет несколько блоков VGG из
Fig. 8.2.1 (также определённых в функции vgg_block). Такая
группировка операций свёртки остаётся практически неизменной на
протяжении последнего десятилетия, хотя конкретный выбор операций
претерпел значительные изменения. Переменная arch содержит список
кортежей (по одному на каждый блок), где каждый кортеж включает два
значения: количество слоёв свёртки и количество выходных каналов. Именно
эти значения являются аргументами, необходимыми для вызова функции
vgg_block. Таким образом, VGG определяет семейство сетей, а не
одну конкретную архитектуру. Чтобы построить конкретную сеть, мы просто
проходим по arch, формируя блоки.
class VGG(d2l.Classifier):
    def __init__(self, arch, lr=0.1, num_classes=10):
        super().__init__()
        self.save_hyperparameters()
        conv_blks = []
        for (num_convs, out_channels) in arch:
            conv_blks.append(vgg_block(num_convs, out_channels))
        self.net = nn.Sequential(
            *conv_blks, nn.Flatten(),
            nn.LazyLinear(4096), nn.ReLU(), nn.Dropout(0.5),
            nn.LazyLinear(4096), nn.ReLU(), nn.Dropout(0.5),
            nn.LazyLinear(num_classes))
        self.net.apply(d2l.init_cnn)
Оригинальная сеть VGG состояла из пяти свёрточных блоков, из которых первые два содержат по одному свёрточному слою, а последние три — по два свёрточных слоя. Первый блок имеет 64 выходных канала, а число выходных каналов в каждом последующем блоке удваивается, пока не достигнет 512. Поскольку эта сеть использует восемь свёрточных слоёв и три полносвязных слоя, её часто называют VGG-11.
VGG(arch=((1, 64), (1, 128), (2, 256), (2, 512), (2, 512))).layer_summary(
    (1, 1, 224, 224))
Как видно, мы уменьшаем высоту и ширину вдвое на каждом блоке, в итоге достигая размеров 7×7 перед тем, как выровнять представления для обработки полносвязной частью сети. Simonyan and Zisserman (2014) описывает несколько других вариантов VGG. На самом деле, стало нормой предлагать семейства сетей с различным компромиссом между скоростью и точностью при представлении новой архитектуры.
8.2.3. Обучение
Поскольку VGG-11 требует больших вычислительных затрат, чем AlexNet, мы создадим сеть с меньшим числом каналов. Это более чем достаточно для обучения на Fashion-MNIST. Процесс обучения модели аналогичен описанному для AlexNet в Section 8.1. Обратите внимание на близкое совпадение функции потерь на валидационной и обучающей выборках, что указывает лишь на незначительное переобучение.
model = VGG(arch=((1, 16), (1, 32), (2, 64), (2, 128), (2, 128)), lr=0.01)
trainer = d2l.Trainer(max_epochs=10, num_gpus=1)
data = d2l.FashionMNIST(batch_size=128, resize=(224, 224))
model.apply_init([next(iter(data.get_dataloader(True)))[0]], d2l.init_cnn)
trainer.fit(model, data)
8.2.4. Итог
Можно утверждать, что VGG стала первой по-настоящему современной свёрточной нейронной сетью. Хотя AlexNet ввёл многие компоненты, обеспечивающие эффективность глубокого обучения в больших масштабах, именно VGG заложила ключевые свойства, такие как использование блоков из нескольких свёрток и предпочтение глубоким и узким сетям. Это также первая сеть, представляющая собой целое семейство моделей с аналогичной параметризацией, что даёт практикующим специалистам широкий выбор компромиссов между сложностью и скоростью. Именно здесь современные фреймворки глубокого обучения демонстрируют свои преимущества. Больше нет необходимости генерировать XML-файлы конфигурации для описания сети; теперь достаточно собрать нужную архитектуру с помощью простого кода на Python.
Недавно в работе ParNet (Goyal et al., 2021) было показано, что с помощью большого числа параллельных вычислений можно достичь конкурентоспособных результатов, используя гораздо более мелкую архитектуру. Это захватывающее развитие событий, и есть надежда, что оно повлияет на проектирование архитектур в будущем. Однако в оставшейся части главы мы будем следовать пути научного прогресса за последнее десятилетие.
8.2.5. Упражнения
По сравнению с AlexNet, VGG значительно медленнее в плане вычислений и требует больше памяти GPU.
Сравните количество параметров, необходимых для AlexNet и VGG.
Сравните количество операций с плавающей запятой, выполняемых в свёрточных слоях и в полносвязных слоях.
Как можно снизить вычислительные затраты, создаваемые полносвязными слоями?
При отображении размерностей, связанных с различными слоями сети, мы видим информацию только для восьми блоков (плюс некоторые вспомогательные преобразования), хотя сеть состоит из 11 слоёв. Куда делись оставшиеся три слоя?
Используя таблицу 1 из статьи VGG (Simonyan and Zisserman, 2014), постройте другие распространённые модели, такие как VGG-16 или VGG-19.
Увеличение разрешения в Fashion-MNIST в восемь раз с \(28 \times 28\) до \(224 \times 224\) пикселей крайне неэффективно. Попробуйте изменить архитектуру сети и способ преобразования разрешения, например, задав размер входа равным 56 или 84 пикселей. Можете ли вы сделать это, не снижая точность сети? Обратитесь к статье VGG (Simonyan and Zisserman, 2014) для получения идей о добавлении нелинейностей перед уменьшением разрешения.