
13.3. Автоматический параллелизм
Фреймворки глубокого обучения (например, MXNet и PyTorch) автоматически строят вычислительные графы на стороне сервера. Используя вычислительный граф, система учитывает все зависимости и может выборочно выполнять несколько независимых задач параллельно для повышения скорости. Например, Fig. 13.2.2 в Section 13.2 инициализирует два объекта независимо. Следовательно, система может выбрать их параллельное выполнение.
Обычно один оператор использует все вычислительные ресурсы всех
процессоров или одного графического процессора. Например, оператор
dot задействует все ядра (и потоки) на всех процессорах, даже если
на одной машине установлено несколько процессоров. То же самое относится
и к одному графическому процессору. Следовательно, параллелизация не так
уж полезна для компьютеров с одним устройством. При использовании
нескольких устройств ситуация меняется. Хотя параллелизация наиболее
актуальна для взаимодействия нескольких графических процессоров,
добавление локального центрального процессора также немного повышает
производительность. Например, см.
Hadjis et al. (2016), где рассматривается обучение
моделей компьютерного зрения с использованием графического и
центрального процессоров. Благодаря удобству фреймворка с автоматической
параллелизацией мы можем достичь той же цели всего несколькими строками
кода на Python. В более широком смысле наше обсуждение автоматического
параллельного вычисления сосредоточено на параллельных вычислениях с
использованием как центральных, так и графических процессоров, а также
на параллелизации вычислений и коммуникаций.
Обратите внимание, что для выполнения экспериментов в этом разделе требуется как минимум два графических процессора.
import torch
from d2l import torch as d2l
13.3.1. Параллельные вычисления на GPU
Начнем с определения эталонной нагрузки для тестирования: функция
run ниже выполняет 10 умножений матриц на устройстве по нашему
выбору, используя данные, выделенные в двух переменных: x_gpu1 и
x_gpu2.
devices = d2l.try_all_gpus()
def run(x):
    return [x.mm(x) for _ in range(50)]

x_gpu1 = torch.rand(size=(4000, 4000), device=devices[0])
x_gpu2 = torch.rand(size=(4000, 4000), device=devices[1])
Теперь мы применяем функцию к данным. Чтобы исключить влияние
кэширования на результаты, мы выполняем один проход на каждом устройстве
перед измерением. torch.cuda.synchronize() ожидает завершения всех
ядер во всех потоках на устройстве CUDA. Он принимает аргумент
device — устройство, для которого необходимо выполнить
синхронизацию. Если аргумент device равен None (по умолчанию),
используется текущее устройство, определяемое через
current_device().
run(x_gpu1)
run(x_gpu2)  # Warm-up all devices
torch.cuda.synchronize(devices[0])
torch.cuda.synchronize(devices[1])

with d2l.Benchmark('GPU1 time'):
    run(x_gpu1)
    torch.cuda.synchronize(devices[0])

with d2l.Benchmark('GPU2 time'):
    run(x_gpu2)
    torch.cuda.synchronize(devices[1])
Если убрать оператор synchronize между обеими задачами, система
сможет автоматически распараллелить вычисления на обоих устройствах.
with d2l.Benchmark('GPU1 & GPU2'):
    run(x_gpu1)
    run(x_gpu2)
    torch.cuda.synchronize()
В приведённом выше случае общее время выполнения меньше суммы времён выполнения отдельных частей, поскольку фреймворк глубокого обучения автоматически планирует вычисления на обоих устройствах GPU без необходимости писать сложный код пользователю.
13.3.2. Параллельные вычисления и коммуникация
Во многих случаях необходимо перемещать данные между различными устройствами, например между процессором и графическим ускорителем или между разными графическими ускорителями. Это происходит, в частности, при выполнении распределенной оптимизации, когда требуется агрегировать градиенты по нескольким картам ускорителей. Давайте смоделируем эту ситуацию, выполнив вычисления на графическом ускорителе, а затем скопировав результаты обратно на процессор.
def copy_to_cpu(x, non_blocking=False):
    return [y.to('cpu', non_blocking=non_blocking) for y in x]

with d2l.Benchmark('Run on GPU1'):
    y = run(x_gpu1)
    torch.cuda.synchronize()

with d2l.Benchmark('Copy to CPU'):
    y_cpu = copy_to_cpu(y)
    torch.cuda.synchronize()
Это несколько неэффективно. Обратите внимание, что мы можем уже начать
копировать части y на процессор, пока остальные элементы списка всё
ещё вычисляются. Такая ситуация возникает, например, при вычислении
градиента (обратного распространения) на мини-батче. Градиенты некоторых
параметров станут доступны раньше, чем градиенты других. Поэтому выгодно
начать использовать пропускную способность шины PCI-Express, пока
графический процессор всё ещё работает. В PyTorch несколько функций,
таких как to() и copy_(), принимают явный аргумент
non_blocking, который позволяет вызывающей стороне обойти
синхронизацию, когда она не требуется. Установка non_blocking=True
позволяет нам смоделировать эту ситуацию.
with d2l.Benchmark('Run on GPU1 and copy to CPU'):
    y = run(x_gpu1)
    y_cpu = copy_to_cpu(y, True)
    torch.cuda.synchronize()
Общее время, необходимое для выполнения обеих операций, (как и следовало
ожидать) меньше суммы времен их выполнения по отдельности. Обратите
внимание, что эта задача отличается от параллельных вычислений,
поскольку использует другой ресурс: шину между процессором и
графическими ускорителями. Фактически, мы можем выполнять вычисления на
обоих устройствах и осуществлять передачу данных одновременно. Как
отмечалось выше, существует зависимость между вычислениями и передачей
данных: y[i] должно быть вычислено, прежде чем его можно будет
скопировать на процессор. К счастью, система может копировать y[i-1]
в то время, как вычисляется y[i], что позволяет сократить общее
время выполнения.
В завершение рассмотрим вычислительный граф и его зависимости для простой двухслойной многослойной перцептрон (MLP) при обучении на процессоре и двух графических процессорах, как показано на рисунке Fig. 13.3.1. Вручную планировать параллельную программу, полученную из этого графа, было бы довольно утомительно. Именно здесь проявляется преимущество использования вычислительного бэкенда на основе графов для оптимизации.
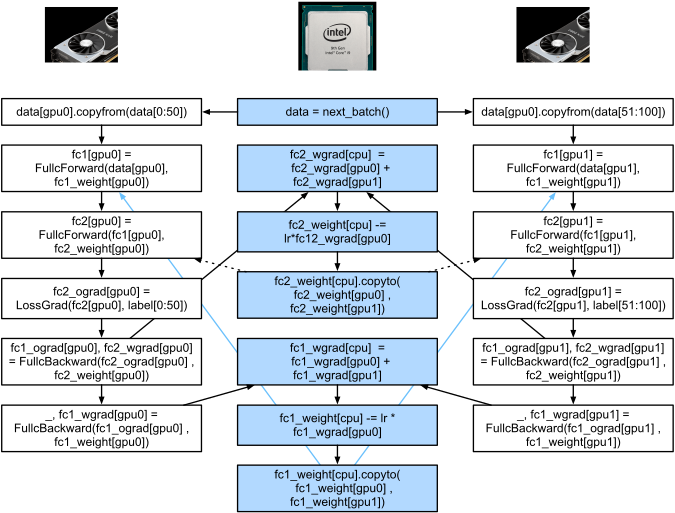
Fig. 13.3.1 Вычислительный граф и его зависимости для двухслойного MLP на процессоре и двух графических ускорителях.
13.3.3. Итоги
Современные системы включают различные устройства, такие как несколько графических процессоров (GPU) и центральных процессоров (CPU). Они могут использоваться параллельно и асинхронно.
Современные системы также обладают разнообразными ресурсами для обмена данными, такими как PCI Express, системы хранения (обычно твердотельные накопители или сетевые хранилища) и пропускная способность сети. Их можно использовать параллельно для достижения максимальной эффективности.
Бэкенд может повысить производительность за счет автоматического параллельного выполнения вычислений и обмена данными.
13.3.4. Упражнения
В функции
run, определённой в этом разделе, было выполнено восемь операций. Между ними нет зависимостей. Разработайте эксперимент, чтобы проверить, будет ли фреймворк глубокого обучения автоматически выполнять их параллельно.Когда нагрузка на отдельную операцию достаточно мала, параллелизация может быть эффективной даже на одном процессоре или графическом процессоре. Разработайте эксперимент для проверки этого утверждения.
Разработайте эксперимент, в котором используются параллельные вычисления на центральных и графических процессорах, а также обмен данными между этими устройствами.
Используйте отладчик, например, Nsight от NVIDIA, чтобы убедиться в эффективности вашего кода.
Разработайте задачи вычислений, включающие более сложные зависимости данных, и проведите эксперименты, чтобы проверить, можно ли получить правильные результаты, одновременно улучшив производительность.