
16.3. Анализ тональности: использование свёрточных нейронных сетей
В Section 7 мы исследовали механизмы обработки двумерных данных изображений с помощью двумерных свёрточных нейронных сетей (CNN), которые применялись к локальным признакам, таким как соседние пиксели. Хотя изначально CNN были разработаны для компьютерного зрения, они также широко используются в обработке естественного языка. Проще говоря, любую текстовую последовательность можно рассматривать как одномерное изображение. Таким образом, одномерные свёрточные нейронные сети могут обрабатывать локальные признаки, такие как \(n\)-граммы в тексте.
В этом разделе мы используем модель textCNN, чтобы продемонстрировать, как спроектировать архитектуру свёрточной нейронной сети для представления одного текста (Kim, 2014). В отличие от Fig. 16.2.1, которая использует архитектуру рекуррентной нейронной сети с предобучением GloVe для анализа тональности, единственное различие в Fig. 16.3.1 заключается в выборе архитектуры.
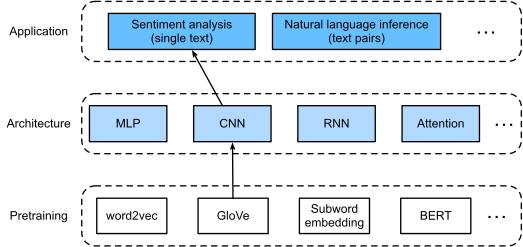
Fig. 16.3.1 В этом разделе мы подаём предварительно обученные векторы GloVe в архитектуру на основе свёрточных нейронных сетей для анализа тональности.
import torch
from torch import nn
from d2l import torch as d2l

batch_size = 64
train_iter, test_iter, vocab = d2l.load_data_imdb(batch_size)
16.3.1. Одномерные свёртки
Прежде чем представить модель, рассмотрим, как работает одномерная свёртка. Имейте в виду, что это всего лишь частный случай двумерной свёртки, основанный на операции кросс-корреляции.
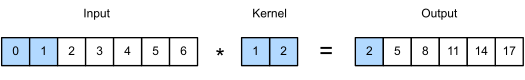
Fig. 16.3.2 Одномерная операция кросс-корреляции. Заштрихованные области обозначают первый выходной элемент, а также элементы входного тензора и ядра, используемые для его вычисления: \(0\times1+1\times2=2\).
Как показано на рисунке Fig. 16.3.2, в одномерном случае окно свёртки скользит слева направо по входному тензору. При перемещении подтензор входных данных (например, \(0\) и \(1\) на рисунке Fig. 16.3.2), находящийся в окне свёртки в определённой позиции, и тензор ядра (например, \(1\) и \(2\) на рисунке Fig. 16.3.2) перемножаются поэлементно. Сумма этих произведений даёт одно скалярное значение (например, \(0\times1+1\times2=2\) на рисунке Fig. 16.3.2) в соответствующей позиции выходного тензора.
Мы реализуем одномерную кросс-корреляцию в следующей corr1d функции.
При заданном входном тензоре X и тензоре ядра K она возвращает
выходной тензор Y.
def corr1d(X, K):
    w = K.shape[0]
    Y = torch.zeros((X.shape[0] - w + 1))
    for i in range(Y.shape[0]):
        Y[i] = (X[i: i + w] * K).sum()
    return Y
Мы можем создать входной тензор X и тензор ядра K из
Fig. 16.3.2, чтобы проверить вывод вышеописанной реализации
одномерной кросс-корреляции.
X, K = torch.tensor([0, 1, 2, 3, 4, 5, 6]), torch.tensor([1, 2])
corr1d(X, K)
Для любого одномерного входа с несколькими каналами ядро свёртки должно иметь то же количество входных каналов. Затем для каждого канала выполняется операция кросс-корреляции между одномерным тензором входа и одномерным тензором ядра свёртки, а результаты суммируются по всем каналам для получения одномерного выходного тензора. Fig. 16.3.3 показывает одномерную операцию кросс-корреляции с 3 входными каналами.
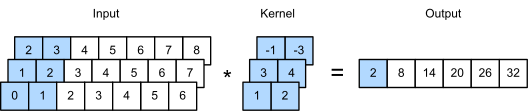
Fig. 16.3.3 Одномерная операция кросс-корреляции с тремя входными каналами. Заштрихованные области обозначают первый элемент выходного тензора, а также элементы входного и ядра тензоров, использованные для его вычисления: \(0\times1+1\times2+1\times3+2\times4+2\times(-1)+3\times(-3)=2\).
Мы можем реализовать операцию одномерной корреляции для нескольких входных каналов и проверить результаты в Fig. 16.3.3.
def corr1d_multi_in(X, K):
    # First, iterate through the 0th dimension (channel dimension) of `X` and
    # `K`. Then, add them together
    return sum(corr1d(x, k) for x, k in zip(X, K))

X = torch.tensor([[0, 1, 2, 3, 4, 5, 6],
              [1, 2, 3, 4, 5, 6, 7],
              [2, 3, 4, 5, 6, 7, 8]])
K = torch.tensor([[1, 2], [3, 4], [-1, -3]])
corr1d_multi_in(X, K)
Обратите внимание, что многоканальные одномерные свёртки эквивалентны одноканальным двумерным свёрткам. Для иллюстрации эквивалентная форма многоканальной одномерной свёртки в Fig. 16.3.3 соответствует одноканальной двумерной свёртке в Fig. 16.3.4, где высота ядра свёртки должна быть равна высоте входного тензора.
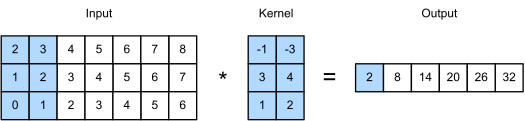
Fig. 16.3.4 Двумерная операция кросс-корреляции с одним входным каналом. Заштрихованные области обозначают первый выходной элемент, а также элементы входного тензора и ядра, использованные для его вычисления: \(2\times(-1)+3\times(-3)+1\times3+2\times4+0\times1+1\times2=2\).
Выходы в Fig. 16.3.2 и Fig. 16.3.3 содержат только один канал. Как и в случае с двумерными свёртками с несколькими выходными каналами, описанными в Section 7.4.2, для одномерных свёрток также можно задать несколько выходных каналов.
16.3.2. Пулинг по максимуму во времени
Аналогичным образом мы можем использовать пулинг для извлечения максимального значения из представлений последовательности, чтобы выделить наиболее важный признак во временных шагах. Пулинг по максимуму во времени, используемый в textCNN, работает так же, как одномерный глобальный пулинг по максимуму (Collobert et al., 2011). Для многоканального входа, где каждый канал хранит значения на разных временных шагах, выходное значение каждого канала равно максимальному значению для этого канала. Обратите внимание, что пулинг по максимуму во времени допускает различное количество временных шагов в разных каналах.
16.3.3. Модель TextCNN
Используя одномерную свёртку и пулинг по максимуму во времени, модель textCNN принимает в качестве входных данных индивидуальные предобученные представления токенов, а затем получает и преобразует представления последовательности для последующих задач.
Для одной текстовой последовательности из \(n\) токенов, представленных векторами размерности \(d\), ширина, высота и число каналов входного тензора равны \(n\), \(1\) и \(d\) соответственно. Модель textCNN преобразует входные данные в выходные следующим образом:
Определим несколько одномерных ядер свёртки и выполним операции свёртки отдельно для входных данных. Ядра свёртки с различной шириной могут захватывать локальные признаки между различным количеством соседних токенов.
Выполним пулинг max-over-time для всех выходных каналов, а затем объединим все скалярные результаты пулинга в вектор.
Преобразуйте объединённый вектор в выходные категории с помощью полносвязного слоя. Для снижения переобучения можно использовать дропаут.
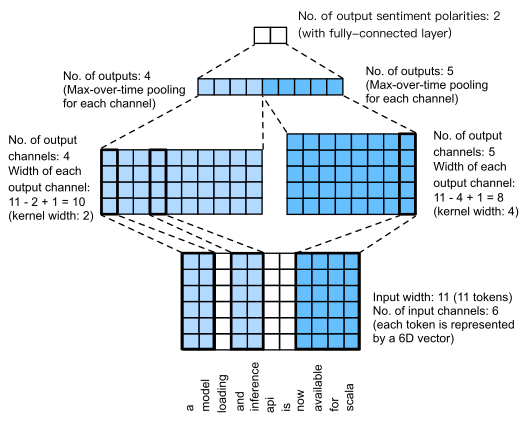
Fig. 16.3.5 Архитектура модели textCNN.
Fig. 16.3.5 иллюстрирует архитектуру модели textCNN на конкретном примере. На вход подаётся предложение из 11 токенов, где каждый токен представлен вектором размерности 6. Таким образом, входные данные имеют 6 каналов и ширину 11. Определим два одномерных свёрточных ядра ширины 2 и 4, формирующих 4 и 5 выходных каналов соответственно. В результате получаем 4 выходных канала ширины \(11-2+1=10\) и 5 выходных каналов ширины \(11-4+1=8\). Несмотря на различную ширину этих 9 каналов, пулинг max-over-time формирует конкатенированный вектор размерности 9, который затем преобразуется в двумерный выходной вектор для предсказания бинарной тональности.
16.3.3.1. Определение модели
Мы реализуем модель textCNN в следующем классе. В отличие от двунаправленной RNN-модели в Section 16.2, помимо замены рекуррентных слоёв на свёрточные, мы также используем два слоя эмбеддингов: один с обучаемыми весами, а другой — с фиксированными.
class TextCNN(nn.Module):
    def __init__(self, vocab_size, embed_size, kernel_sizes, num_channels,
                 **kwargs):
        super(TextCNN, self).__init__(**kwargs)
        self.embedding = nn.Embedding(vocab_size, embed_size)
        # The embedding layer not to be trained
        self.constant_embedding = nn.Embedding(vocab_size, embed_size)
        self.dropout = nn.Dropout(0.5)
        self.decoder = nn.Linear(sum(num_channels), 2)
        # The max-over-time pooling layer has no parameters, so this instance
        # can be shared
        self.pool = nn.AdaptiveAvgPool1d(1)
        self.relu = nn.ReLU()
        # Create multiple one-dimensional convolutional layers
        self.convs = nn.ModuleList()
        for c, k in zip(num_channels, kernel_sizes):
            self.convs.append(nn.Conv1d(2 * embed_size, c, k))

    def forward(self, inputs):
        # Concatenate two embedding layer outputs with shape (batch size, no.
        # of tokens, token vector dimension) along vectors
        embeddings = torch.cat((
            self.embedding(inputs), self.constant_embedding(inputs)), dim=2)
        # Per the input format of one-dimensional convolutional layers,
        # rearrange the tensor so that the second dimension stores channels
        embeddings = embeddings.permute(0, 2, 1)
        # For each one-dimensional convolutional layer, after max-over-time
        # pooling, a tensor of shape (batch size, no. of channels, 1) is
        # obtained. Remove the last dimension and concatenate along channels
        encoding = torch.cat([
            torch.squeeze(self.relu(self.pool(conv(embeddings))), dim=-1)
            for conv in self.convs], dim=1)
        outputs = self.decoder(self.dropout(encoding))
        return outputs
Создадим объект textCNN. Он содержит три свёрточных слоя с размерами ядер 3, 4 и 5, каждый из которых имеет 100 выходных каналов.
embed_size, kernel_sizes, nums_channels = 100, [3, 4, 5], [100, 100, 100]
devices = d2l.try_all_gpus()
net = TextCNN(len(vocab), embed_size, kernel_sizes, nums_channels)

def init_weights(module):
    if type(module) in (nn.Linear, nn.Conv1d):
        nn.init.xavier_uniform_(module.weight)

net.apply(init_weights);
16.3.3.2. Загрузка предобученных векторов слов
Как и в Section 16.2, мы загружаем предварительно
обученные 100-мерные эмбеддинги GloVe в качестве инициализированных
представлений токенов. Эти представления токенов (веса эмбеддингов)
будут обучаться в embedding и зафиксированы в
constant_embedding.
glove_embedding = d2l.TokenEmbedding('glove.6b.100d')
embeds = glove_embedding[vocab.idx_to_token]
net.embedding.weight.data.copy_(embeds)
net.constant_embedding.weight.data.copy_(embeds)
net.constant_embedding.weight.requires_grad = False
16.3.3.3. Обучение и оценка модели
Теперь мы можем обучить модель textCNN для анализа тональности текста.
lr, num_epochs = 0.001, 5
trainer = torch.optim.Adam(net.parameters(), lr=lr)
loss = nn.CrossEntropyLoss(reduction="none")
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs, devices)
Ниже мы используем обученную модель для предсказания тональности двух простых предложений.
d2l.predict_sentiment(net, vocab, 'this movie is so great')
d2l.predict_sentiment(net, vocab, 'this movie is so bad')
16.3.4. Итоги
Одномерные свёрточные нейронные сети могут обрабатывать локальные признаки, такие как \(n\)-граммы в тексте.
Многоканальные одномерные кросс-корреляции эквивалентны одноканальным двумерным кросс-корреляциям.
Пулинг по максимуму во времени допускает различное количество временных шагов для разных каналов.
Модель TextCNN преобразует представления отдельных токенов в выходные данные для последующих задач с помощью одномерных свёрточных слоёв и слоёв пулинга max-over-time.
16.3.5. Упражнения
Настройте гиперпараметры и сравните две архитектуры для анализа тональности, рассмотренные в Section 16.2 и в этом разделе, например, по точности классификации и вычислительной эффективности.
Можно ли дополнительно повысить точность классификации модели, используя методы, рассмотренные в упражнениях Section 16.2?
Добавьте позиционное кодирование во входные представления. Улучшает ли это точность классификации?