
5.7. Прогнозирование цен на дома на Kaggle
Теперь, когда мы познакомились с основными инструментами для построения и обучения глубоких сетей и их регуляризации с помощью таких методов, как затухание весов и дропаут, мы готовы применить эти знания на практике, приняв участие в соревновании на Kaggle. Соревнование по прогнозированию цен на жилье — отличное место для начала. Данные достаточно типичны и не обладают экзотической структурой, которая могла бы потребовать специализированных моделей (как, например, в случае с аудио или видео). Этот набор данных, собранный De Cock (2011), охватывает цены на жилье в Эймсе, штат Айова, за период 2006–2010 годов. Он значительно больше, чем знаменитый набор данных по жилью в Бостоне Харрисона и Рубинфелда (1978), предлагая как больше примеров, так и больше признаков.
В этом разделе мы подробно рассмотрим предобработку данных, проектирование модели и выбор гиперпараметров. Мы надеемся, что практический подход поможет вам развить интуицию, которая будет направлять вас в вашей карьере в области науки о данных.
%matplotlib inline
import pandas as pd
import torch
from torch import nn
from d2l import torch as d2l
5.7.1. Скачивание данных
На протяжении всей книги мы будем обучать и проверять модели на различных загружаемых наборах данных. В этом разделе мы реализуем две вспомогательные функции для загрузки и распаковки zip- или tar-архивов. Как и ранее, мы опустим детали реализации таких вспомогательных функций.
def download(url, folder, sha1_hash=None):
    """Download a file to folder and return the local filepath."""

def extract(filename, folder):
    """Extract a zip/tar file into folder."""
5.7.2. Kaggle
Kaggle — это популярная платформа, на которой проводятся соревнования по машинному обучению. Каждое соревнование основано на определённом наборе данных, и многие из них спонсируются заинтересованными сторонами, предлагающими призы за лучшие решения. Платформа способствует взаимодействию пользователей через форумы и общий код, поддерживая как сотрудничество, так и конкуренцию. Хотя погоня за высокими местами в таблице лидеров часто выходит из-под контроля, заставляя исследователей узконаправленно сосредотачиваться на этапах предобработки данных вместо того, чтобы задавать фундаментальные вопросы, в объективности платформы, обеспечивающей прямое количественное сравнение конкурирующих подходов, а также обмен кодом, чтобы каждый мог узнать, что сработало, а что нет, заключена огромная ценность. Если вы хотите принять участие в соревновании на Kaggle, вам сначала необходимо зарегистрировать учётную запись (см. Fig. 5.7.1).
Fig. 5.7.1 Веб-сайт Kaggle.
На странице соревнования по прогнозированию цен на жилье, как показано на рисунке Fig. 5.7.2, вы можете найти набор данных (на вкладке «Data»), отправить свои прогнозы и посмотреть свое место в рейтинге. Ссылка на страницу находится здесь:
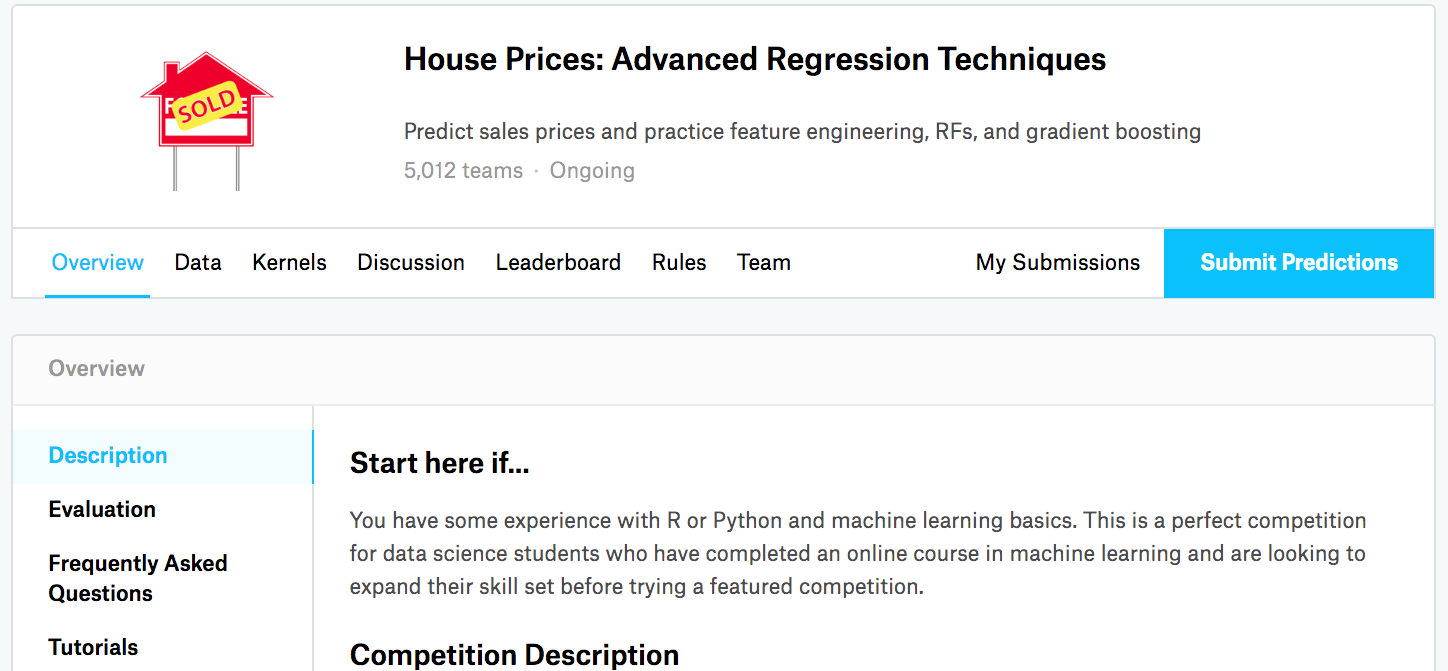
Fig. 5.7.2 Страница соревнования по прогнозированию цен на жилье.
5.7.3. Доступ к набору данных и его чтение
Обратите внимание, что данные соревнования разделены на обучающую и тестовую выборки. Каждая запись содержит значение стоимости дома и такие атрибуты, как тип улицы, год постройки, тип крыши, состояние подвала и т. д. Признаки представлены в различных форматах данных. Например, год постройки задан целым числом, тип крыши — дискретными категориальными значениями, а другие признаки — числами с плавающей запятой. Здесь реальность усложняет задачу: для некоторых примеров часть данных полностью отсутствует, а пропущенные значения обозначены как «na». Стоимость каждого дома указана только для обучающей выборки (ведь это соревнование). Мы хотим разделить обучающую выборку, чтобы получить валидационную, но оценивать наши модели мы сможем только на официальной тестовой выборке после загрузки предсказаний на Kaggle. Ссылки для скачивания данных находятся на вкладке «Data» в разделе соревнования Fig. 5.7.2.
Чтобы начать, мы прочитаем и обработаем данные с помощью ``pandas``,
которые мы рассматривали в Section 2.2. Для удобства мы можем
загрузить и закэшировать набор данных Kaggle по ценам на жилье. Если
файл, соответствующий этому набору данных, уже существует в каталоге
кэша и его хеш SHA-1 совпадает со значением sha1_hash, наш код будет
использовать закэшированный файл, чтобы избежать избыточных загрузок и
не засорять интернет-канал.
class KaggleHouse(d2l.DataModule):
    def __init__(self, batch_size, train=None, val=None):
        super().__init__()
        self.save_hyperparameters()
        if self.train is None:
            self.raw_train = pd.read_csv(d2l.download(
                d2l.DATA_URL + 'kaggle_house_pred_train.csv', self.root,
                sha1_hash='585e9cc93e70b39160e7921475f9bcd7d31219ce'))
            self.raw_val = pd.read_csv(d2l.download(
                d2l.DATA_URL + 'kaggle_house_pred_test.csv', self.root,
                sha1_hash='fa19780a7b011d9b009e8bff8e99922a8ee2eb90'))
Обучающий набор данных включает 1460 примеров, 80 признаков и одну метку, тогда как валидационные данные содержат 1459 примеров и 80 признаков.
data = KaggleHouse(batch_size=64)
print(data.raw_train.shape)
print(data.raw_val.shape)
5.7.4. Предобработка данных
Давайте рассмотрим первые четыре и последние два признака, а также метку (SalePrice) для первых четырёх примеров.
print(data.raw_train.iloc[:4, [0, 1, 2, 3, -3, -2, -1]])
Мы видим, что в каждом примере первый признак является идентификатором. Это помогает модели различать обучающие примеры. Хотя это удобно, данный признак не содержит информации, полезной для предсказания. Поэтому мы удалим его из набора данных перед подачей данных в модель. Кроме того, учитывая разнообразие типов данных, нам потребуется предварительная обработка данных перед началом построения модели.
Начнем с числовых признаков. Сначала применим эвристику, заменяя все пропущенные значения средним значением соответствующего признака. Затем, чтобы привести все признаки к единой шкале, мы стандартизируем данные, приведя признаки к нулевому среднему и единичной дисперсии:
где \(\mu\) и \(\sigma\) обозначают среднее значение и стандартное отклонение соответственно. Чтобы убедиться, что эта трансформация действительно приводит признак (переменную) к нулевому среднему и единичной дисперсии, заметим, что \(E[\frac{x-\mu}{\sigma}] = \frac{\mu - \mu}{\sigma} = 0\) и что \(E[(x-\mu)^2] = (\sigma^2 + \mu^2) - 2\mu^2+\mu^2 = \sigma^2\). Интуитивно мы стандартизируем данные по двум причинам. Во-первых, это удобно для оптимизации. Во-вторых, поскольку нам заранее неизвестно, какие именно признаки будут релевантны, мы не хотим штрафовать коэффициенты, присвоенные одному признаку, сильнее, чем коэффициенты любого другого.
Далее мы рассмотрим дискретные значения. К ним относятся признаки, такие
как «MSZoning». Мы заменяем их с помощью кодирования одним из N
вариантов тем же способом, которым ранее преобразовывали многоклассовые
метки в векторы (см. Section 4.1.1).
Например, «MSZoning» принимает значения «RL» и «RM». Вместо признака
«MSZoning» создаются два новых индикаторных признака «MSZoning_RL» и
«MSZoning_RM», значения которых могут быть либо 0, либо 1. Согласно
кодированию одним из N вариантов, если исходное значение «MSZoning»
равно «RL», то «MSZoning_RL» равно 1, а «MSZoning_RM» равно 0. Пакет
pandas выполняет эту операцию автоматически.
@d2l.add_to_class(KaggleHouse)
def preprocess(self):
    # Remove the ID and label columns
    label = 'SalePrice'
    features = pd.concat(
        (self.raw_train.drop(columns=['Id', label]),
         self.raw_val.drop(columns=['Id'])))
    # Standardize numerical columns
    numeric_features = features.dtypes[features.dtypes!='object'].index
    features[numeric_features] = features[numeric_features].apply(
        lambda x: (x - x.mean()) / (x.std()))
    # Replace NAN numerical features by 0
    features[numeric_features] = features[numeric_features].fillna(0)
    # Replace discrete features by one-hot encoding
    features = pd.get_dummies(features, dummy_na=True)
    # Save preprocessed features
    self.train = features[:self.raw_train.shape[0]].copy()
    self.train[label] = self.raw_train[label]
    self.val = features[self.raw_train.shape[0]:].copy()
Как видно, это преобразование увеличивает количество признаков с 79 до 331 (исключая столбцы ID и метки).
data.preprocess()
data.train.shape
5.7.5. Мера ошибки
Для начала мы обучим линейную модель с квадратичной функцией потерь. Неудивительно, что наша линейная модель не позволит нам занять призовое место на соревновании, но она служит проверкой на адекватность, чтобы убедиться, что в данных содержится осмысленная информация. Если мы не сможем превзойти случайное угадывание, это может означать, что в обработке данных есть ошибка. Если же всё работает, линейная модель послужит базовым решением, которое даст нам представление о том, насколько простая модель приближается к лучшим из опубликованных результатов, и поможет оценить, какой прирост производительности мы можем ожидать от более сложных моделей.
При прогнозировании цен на жилье, как и при прогнозировании цен на акции, мы больше заботимся о относительных величинах, чем об абсолютных. Поэтому мы обычно уделяем больше внимания относительной ошибке \(\frac{y - \hat{y}}{y}\), чем абсолютной ошибке \(y - \hat{y}\). Например, если наше предсказание отличается от истинной цены объекта в сельской части Огайо, где значение типичного дома составляет 125 000 долларов, на 100 000 долларов, то, вероятно, мы работаем очень плохо. С другой стороны, если мы допускаем такую же ошибку в Лос-Альтос-Хиллз (Калифорния), это может означать поразительно точное предсказание (там медианная цена дома превышает 4 миллиона долларов).
Одним из способов решения этой проблемы является измерение расхождения в логарифмах оценок стоимости. На самом деле, это также официальная мера ошибки, используемая в соревновании для оценки качества представленных решений. В конце концов, малое значение \(\delta\) для \(|\log y - \log \hat{y}| \leq \delta\) приводит к \(e^{-\delta} \leq \frac{\hat{y}}{y} \leq e^\delta\). Это приводит к следующей среднеквадратичной ошибке между логарифмом предсказанной цены и логарифмом метки цены:
@d2l.add_to_class(KaggleHouse)
def get_dataloader(self, train):
    label = 'SalePrice'
    data = self.train if train else self.val
    if label not in data: return
    get_tensor = lambda x: torch.tensor(x.values.astype(float),
                                      dtype=torch.float32)
    # Logarithm of prices
    tensors = (get_tensor(data.drop(columns=[label])),  # X
               torch.log(get_tensor(data[label])).reshape((-1, 1)))  # Y
    return self.get_tensorloader(tensors, train)
5.7.6. \(K\)-кратная перекрёстная проверка
Возможно, вы помните, что мы ввели понятие кросс-валидации в Section 3.6.3, где обсуждали, как решать задачу выбора модели. Мы будем активно использовать этот подход для выбора архитектуры модели и настройки гиперпараметров. Сначала нам понадобится функция, которая возвращает \(i^\textrm{th}\)-ю часть данных в рамках \(K\)-кратной кросс-валидации. Она работает следующим образом: выделяет \(i^\textrm{th}\)-й сегмент в качестве валидационных данных, а остальные данные возвращает в качестве обучающих. Обратите внимание, что это не самый эффективный способ обработки данных, и если бы наш набор данных был значительно больше, мы бы наверняка применили более разумный подход. Однако эта дополнительная сложность может излишне запутать код, поэтому в силу простоты нашей задачи мы можем смело ею пренебречь.
def k_fold_data(data, k):
    rets = []
    fold_size = data.train.shape[0] // k
    for j in range(k):
        idx = range(j * fold_size, (j+1) * fold_size)
        rets.append(KaggleHouse(data.batch_size, data.train.drop(index=idx),
                                data.train.loc[idx]))
    return rets
Возвращается средняя ошибка валидации при обучении \(K\) раз в \(K\)-кратной перекрёстной проверке.
def k_fold(trainer, data, k, lr):
    val_loss, models = [], []
    for i, data_fold in enumerate(k_fold_data(data, k)):
        model = d2l.LinearRegression(lr)
        model.board.yscale='log'
        if i != 0: model.board.display = False
        trainer.fit(model, data_fold)
        val_loss.append(float(model.board.data['val_loss'][-1].y))
        models.append(model)
    print(f'average validation log mse = {sum(val_loss)/len(val_loss)}')
    return models
5.7.7. Выбор модели
В этом примере мы выбираем набор гиперпараметров без их настройки и оставляем улучшение модели на усмотрение читателя. Поиск хорошего варианта может занять время в зависимости от количества переменных, по которым проводится оптимизация. При наличии достаточно большого набора данных и стандартных гиперпараметров \(K\)-кратная перекрёстная проверка обычно достаточно устойчива к проблеме множественного тестирования. Однако, если мы попробуем слишком большое количество вариантов, может оказаться, что производительность на валидационном наборе данных больше не отражает истинную ошибку.
trainer = d2l.Trainer(max_epochs=10)
models = k_fold(trainer, data, k=5, lr=0.01)
Обратите внимание, что иногда количество ошибок на обучающих данных для набора гиперпараметров может быть очень низким, даже когда количество ошибок при \(K\)-кратной перекрёстной проверке значительно возрастает. Это указывает на то, что мы переобучаемся. В процессе обучения следует отслеживать оба этих показателя. Слабое переобучение может означать, что наши данные позволяют использовать более мощную модель. Сильное переобучение может свидетельствовать о том, что применение методов регуляризации способно улучшить результаты.
5.7.8. Отправка предсказаний на Kaggle
Теперь, когда мы знаем, какие гиперпараметры следует выбрать, мы можем
вычислить средние предсказания для всех \(K\) моделей на тестовой
выборке. Сохранение предсказаний в файл CSV упростит загрузку
результатов на Kaggle. Приведённый ниже код создаст файл с именем
submission.csv.
preds = [model(torch.tensor(data.val.values.astype(float), dtype=torch.float32))
         for model in models]
# Taking exponentiation of predictions in the logarithm scale
ensemble_preds = torch.exp(torch.cat(preds, 1)).mean(1)
submission = pd.DataFrame({'Id':data.raw_val.Id,
                           'SalePrice':ensemble_preds.detach().numpy()})
submission.to_csv('submission.csv', index=False)
Далее, как показано в Fig. 5.7.3, мы можем отправить наши предсказания на Kaggle и посмотреть, как они соотносятся с реальными ценами на дома (метками) в тестовой выборке. Шаги довольно просты:
Войдите на сайт Kaggle и перейдите на страницу соревнования по предсказанию цен на дома.
Нажмите кнопку «Submit Predictions» или «Late Submission».
Нажмите кнопку «Upload Submission File» в пунктирной рамке внизу страницы и выберите файл с предсказаниями, который вы хотите загрузить.
Нажмите кнопку «Make Submission» внизу страницы, чтобы просмотреть свои результаты.
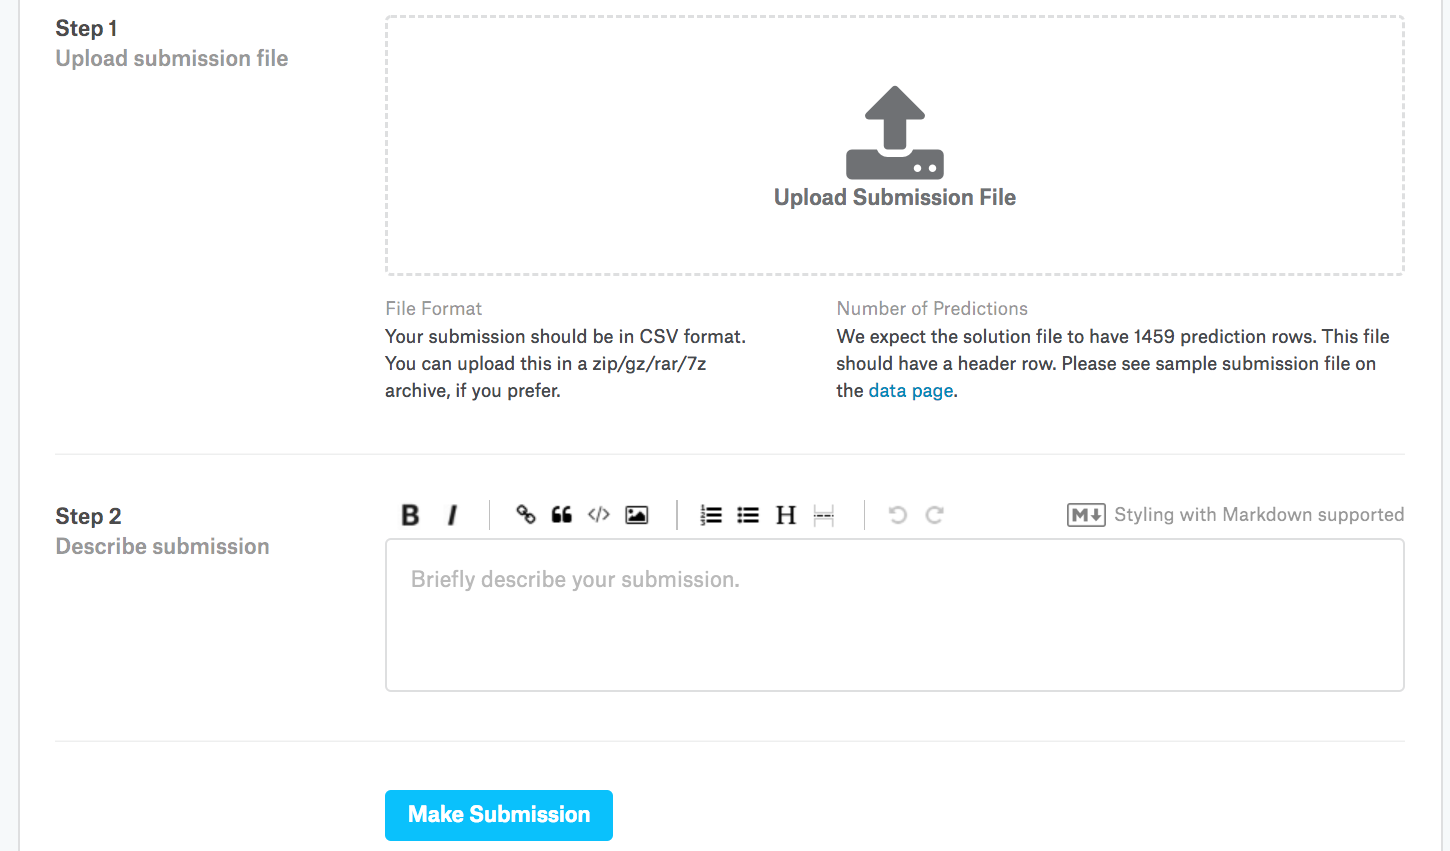
Fig. 5.7.3 Отправка данных на Kaggle.
5.7.9. Итоги и обсуждение
Реальные данные часто содержат смесь различных типов данных и требуют предварительной обработки. Приведение вещественных данных к нулевому среднему и единичной дисперсии является хорошим выбором по умолчанию. То же самое относится и к замене пропущенных значений их средним. Кроме того, преобразование категориальных признаков в индикаторные позволяет рассматривать их как one-hot векторы. Когда мы больше заботимся об относительной ошибке, чем об абсолютной, мы можем измерять расхождение в логарифме предсказания. Для выбора модели и настройки гиперпараметров мы можем использовать \(K\)-кратную перекрёстную проверку.
5.7.10. Упражнения
Отправьте свои предсказания по этому разделу на Kaggle. Насколько они хороши?
Всегда ли целесообразно заменять пропущенные значения средним? Подсказка: можно ли привести пример ситуации, в которой значения отсутствуют неслучайным образом?
Улучшите показатель, настроив гиперпараметры с помощью \(K\)-кратной перекрёстной проверки.
Улучшите показатель, улучшив модель (например, количество слоёв, затухание весов и дропаут).
Что произойдет, если мы не будем стандартизировать непрерывные числовые признаки, как это было сделано в данном разделе?