
10.7. Обучение последовательность-в-последовательность для машинного перевода
В задачах так называемого обучения «последовательность в последовательность», таких как машинный перевод (обсуждаемый в Section 10.5), где входные и выходные данные представляют собой не выровненные последовательности переменной длины, мы обычно используем архитектуры кодировщик–декодировщик (Section 10.6). В этом разделе мы продемонстрируем применение архитектуры кодировщик–декодировщик, в которой и кодировщик, и декодировщик реализованы в виде рекуррентных нейронных сетей, к задаче машинного перевода (Cho et al., 2014, Sutskever et al., 2014).
Здесь кодировщик RNN принимает на вход последовательность переменной длины и преобразует её в скрытое состояние фиксированной формы. Позже, в Section 11, мы рассмотрим механизмы внимания, которые позволяют обращаться к закодированным входным данным, не сжимая всю входную последовательность в одно представление фиксированной длины.
Затем, для генерации выходной последовательности по одному токену за раз, модель декодировщика, состоящая из отдельной рекуррентной нейронной сети, будет предсказывать каждый следующий токен целевой переменной на основе входной последовательности и предыдущих токенов в выходных данных. Во время обучения декодировщик обычно ориентируется на предыдущие токены из официальной «эталонной» метки. Однако на этапе тестирования мы хотим, чтобы каждый выход декодировщика зависел от уже предсказанных токенов. Обратите внимание, что если игнорировать кодировщик, то декодировщик в архитектуре «последовательность-в-последовательность» ведёт себя как обычная языковая модель. Fig. 10.7.1 иллюстрирует, как использовать две рекуррентные нейронные сети для обучения машинному переводу методом «последовательность-в-последовательность».
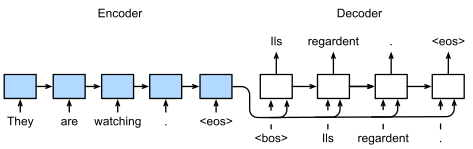
Fig. 10.7.1 Обучение последовательность-в-последовательность с RNN-кодировщиком и RNN-декодировщиком.
В Fig. 10.7.1 специальный токен “<eos>” обозначает конец последовательности. Наша модель может прекратить генерацию предсказаний, как только этот токен будет сгенерирован. При инициализации RNN-декодировщика на начальном временном шаге следует учитывать два архитектурных решения. Во-первых, каждый вход начинается со специального токена начала последовательности “<bos>”. Во-вторых, финальное скрытое состояние кодировщика может подаваться на декодировщик на каждом шаге декодирования (Cho et al., 2014). В некоторых других архитектурах, например в Sutskever et al. (2014), финальное скрытое состояние RNN-кодировщика используется для инициализации скрытого состояния декодировщика только на первом шаге декодирования.
import collections
import math
import torch
from torch import nn
from torch.nn import functional as F
from d2l import torch as d2l
10.7.1. Принудительное обучение учителя
Хотя запуск кодировщика на входной последовательности относительно прост, обработка входа и выхода декодировщика требует большей тщательности. Наиболее распространенный подход иногда называют teacher forcing. В этом случае исходная целевая последовательность (метки токенов) подается на вход декодировщика. Более конкретно, в качестве входа декодировщика используется конкатенация специального токена начала последовательности и исходной целевой последовательности без последнего токена, тогда как выход декодировщика (метки для обучения) представляет собой исходную целевую последовательность, сдвинутую на один токен: “<bos>”, “Ils”, “regardent”, “.” \(\rightarrow\) “Ils”, “regardent”, “.”, “<eos>” (Fig. 10.7.1).
В реализации в Section 10.5.3 данные для teacher forcing готовились так, что сдвиг токенов для самообучения аналогичен обучению языковых моделей в Section 9.3. Альтернативный подход заключается в подаче на вход декодировщику предсказанного токена с предыдущего временного шага в качестве текущего входа.
В дальнейшем мы подробно рассмотрим архитектуру, изображенную на рисунке Fig. 10.7.1. Мы обучим эту модель для машинного перевода на англо-французском наборе данных, описанном в Section 10.5.
10.7.2. Кодировщик
Напомним, что кодировщик преобразует входную последовательность переменной длины в контекстную переменную фиксированной формы \(\mathbf{c}\) (см. Fig. 10.7.1).
Рассмотрим один пример последовательности (размер батча равен 1). Предположим, что входная последовательность имеет вид \(x_1, \ldots, x_T\), где \(x_t\) — это токен \(t^{\textrm{th}}\). На шаге времени \(t\) рекуррентная нейронная сеть преобразует входной вектор признаков \(\mathbf{x}_t\) для токена \(x_t\) и скрытое состояние \(\mathbf{h} _{t-1}\) с предыдущего шага времени в текущее скрытое состояние \(\mathbf{h}_t\). Преобразование рекуррентного слоя RNN можно выразить с помощью функции \(f\):
В общем случае кодировщик преобразует скрытые состояния на всех временных шагах в контекстную переменную с помощью специальной функции \(q\):
Например, в Fig. 10.7.1 контекстная переменная — это просто скрытое состояние \(\mathbf{h}_T\), соответствующее представлению кодировщика RNN после обработки последнего токена входной последовательности.
В этом примере мы использовали однонаправленный RNN для создания кодировщика, в котором скрытое состояние зависит только от подпоследовательности входных данных на текущем и предыдущих временных шагах. Мы также можем конструировать кодировщики на основе двунаправленных RNN. В этом случае скрытое состояние зависит от подпоследовательности до и после текущего временного шага (включая входные данные на текущем временном шаге), что позволяет закодировать информацию всей последовательности.
Теперь давайте реализуем кодировщик RNN. Обратите внимание, что мы
используем слой эмбеддингов для получения вектора признаков каждого
токена во входной последовательности. Вес слоя эмбеддингов — это
матрица, в которой количество строк соответствует размеру входного
словаря (vocab_size), а количество столбцов — размерности вектора
признаков (embed_size). Для любого индекса входного токена \(i\)
слой эмбеддингов извлекает строку \(i^{\textrm{th}}\) (отсчёт
начинается с нуля) матрицы весов, чтобы вернуть её вектор признаков.
Здесь мы реализуем кодировщик на основе многослойного GRU.
def init_seq2seq(module):  #@save
    """Initialize weights for sequence-to-sequence learning."""
    if type(module) == nn.Linear:
         nn.init.xavier_uniform_(module.weight)
    if type(module) == nn.GRU:
        for param in module._flat_weights_names:
            if "weight" in param:
                nn.init.xavier_uniform_(module._parameters[param])
class Seq2SeqEncoder(d2l.Encoder):  #@save
    """The RNN encoder for sequence-to-sequence learning."""
    def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
                 dropout=0):
        super().__init__()
        self.embedding = nn.Embedding(vocab_size, embed_size)
        self.rnn = d2l.GRU(embed_size, num_hiddens, num_layers, dropout)
        self.apply(init_seq2seq)

    def forward(self, X, *args):
        # X shape: (batch_size, num_steps)
        embs = self.embedding(X.t().type(torch.int64))
        # embs shape: (num_steps, batch_size, embed_size)
        outputs, state = self.rnn(embs)
        # outputs shape: (num_steps, batch_size, num_hiddens)
        # state shape: (num_layers, batch_size, num_hiddens)
        return outputs, state
Рассмотрим конкретный пример, чтобы проиллюстрировать реализацию
описанного выше кодировщика. Ниже мы создадим двухслойный кодировщик GRU
с 16 скрытыми единицами. Для мини-батча входных последовательностей
X (размер батча \(=4\); количество временных шагов \(=9\))
скрытые состояния последнего слоя на всех временных шагах
(enc_outputs, возвращаемые рекуррентными слоями кодировщика)
представляют собой тензор формы (количество временных шагов, размер
батча, количество скрытых единиц).
vocab_size, embed_size, num_hiddens, num_layers = 10, 8, 16, 2
batch_size, num_steps = 4, 9
encoder = Seq2SeqEncoder(vocab_size, embed_size, num_hiddens, num_layers)
X = torch.zeros((batch_size, num_steps))
enc_outputs, enc_state = encoder(X)
d2l.check_shape(enc_outputs, (num_steps, batch_size, num_hiddens))
Поскольку здесь используется GRU, форма многоуровневых скрытых состояний на последнем временном шаге равна (число скрытых слоёв, размер батча, число скрытых единиц).
d2l.check_shape(enc_state, (num_layers, batch_size, num_hiddens))
10.7.3. Декодировщик
Для каждой целевой выходной последовательности \(y_1, y_2, \ldots, y_{T'}\) на каждом временном шаге \(t'\) (мы используем \(t^\prime\), чтобы отличить временные шаги входной последовательности), декодировщик присваивает предсказанную вероятность каждому возможному токену, появляющемуся на шаге \(y_{t'+1}\), при условии предыдущих токенов в целевой последовательности \(y_1, \ldots, y_{t'}\) и контекстной переменной \(\mathbf{c}\), т. е. \(P(y_{t'+1} \mid y_1, \ldots, y_{t'}, \mathbf{c})\).
Для предсказания следующего \(t^\prime+1\) токена в целевой последовательности декодировщик RNN принимает в качестве входных данных токен целевой переменной с предыдущего шага \(y_{t^\prime}\), скрытое состояние RNN с предыдущего временного шага \(\mathbf{s}_{t^\prime-1}\) и контекстную переменную \(\mathbf{c}\), преобразуя их в скрытое состояние \(\mathbf{s}_{t^\prime}\) на текущем временном шаге. Преобразование скрытого слоя декодировщика можно выразить с помощью функции \(g\):
Получив скрытое состояние декодировщика, мы можем использовать выходной слой и операцию софтмакс для вычисления предсказуемого распределения \(p(y_{t^{\prime}+1} \mid y_1, \ldots, y_{t^\prime}, \mathbf{c})\) над следующим выходным токеном \({t^\prime+1}\).
Следуя Fig. 10.7.1, при реализации декодировщика мы напрямую используем скрытое состояние на последнем временном шаге кодировщика для инициализации скрытого состояния декодировщика. Это требует, чтобы RNN-кодировщик и RNN-декодировщик имели одинаковое количество слоёв и скрытых единиц. Чтобы дополнительно использовать закодированную информацию входной последовательности, контекстная переменная объединяется с входом декодировщика на всех временных шагах. Для предсказания распределения вероятностей выходного токена мы используем полносвязный слой для преобразования скрытого состояния на последнем слое RNN-декодировщика.
class Seq2SeqDecoder(d2l.Decoder):
    """The RNN decoder for sequence to sequence learning."""
    def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
                 dropout=0):
        super().__init__()
        self.embedding = nn.Embedding(vocab_size, embed_size)
        self.rnn = d2l.GRU(embed_size+num_hiddens, num_hiddens,
                           num_layers, dropout)
        self.dense = nn.LazyLinear(vocab_size)
        self.apply(init_seq2seq)

    def init_state(self, enc_all_outputs, *args):
        return enc_all_outputs

    def forward(self, X, state):
        # X shape: (batch_size, num_steps)
        # embs shape: (num_steps, batch_size, embed_size)
        embs = self.embedding(X.t().type(torch.int32))
        enc_output, hidden_state = state
        # context shape: (batch_size, num_hiddens)
        context = enc_output[-1]
        # Broadcast context to (num_steps, batch_size, num_hiddens)
        context = context.repeat(embs.shape[0], 1, 1)
        # Concat at the feature dimension
        embs_and_context = torch.cat((embs, context), -1)
        outputs, hidden_state = self.rnn(embs_and_context, hidden_state)
        outputs = self.dense(outputs).swapaxes(0, 1)
        # outputs shape: (batch_size, num_steps, vocab_size)
        # hidden_state shape: (num_layers, batch_size, num_hiddens)
        return outputs, [enc_output, hidden_state]
Чтобы проиллюстрировать реализованный декодировщик, ниже мы создадим его экземпляр, используя те же гиперпараметры, что и у упомянутого выше кодировщика. Как видно, форма выхода декодировщика равна (размер батча, количество временных шагов, размер словаря), где последняя размерность тензора хранит предсказанное распределение токенов.
decoder = Seq2SeqDecoder(vocab_size, embed_size, num_hiddens, num_layers)
state = decoder.init_state(encoder(X))
dec_outputs, state = decoder(X, state)
d2l.check_shape(dec_outputs, (batch_size, num_steps, vocab_size))
d2l.check_shape(state[1], (num_layers, batch_size, num_hiddens))
Слои в приведённой выше модели кодировщик–декодировщик на базе RNN обобщены в Fig. 10.7.2.
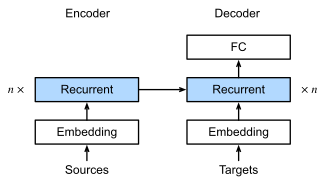
Fig. 10.7.2 Слои в модели кодировщика–декодировщика на основе RNN.
10.7.4. Кодировщик–декодировщик для обучения последовательность-в-последовательность
Объединение всех элементов в коде дает следующий результат:
class Seq2Seq(d2l.EncoderDecoder):  #@save
    """The RNN encoder--decoder for sequence to sequence learning."""
    def __init__(self, encoder, decoder, tgt_pad, lr):
        super().__init__(encoder, decoder)
        self.save_hyperparameters()

    def validation_step(self, batch):
        Y_hat = self(*batch[:-1])
        self.plot('loss', self.loss(Y_hat, batch[-1]), train=False)

    def configure_optimizers(self):
        # Adam optimizer is used here
        return torch.optim.Adam(self.parameters(), lr=self.lr)
10.7.5. Функция потерь с маскировкой
На каждом временном шаге декодировщик предсказывает распределение вероятностей для выходных токенов. Как и в языковом моделировании, мы можем применить софтмакс для получения распределения и вычислить перекрёстную энтропию для оптимизации. Вспомним из Section 10.5, что специальные токены дополнения добавляются в конец последовательностей, благодаря чему последовательности разной длины можно эффективно загружать мини-пакетами одинаковой формы. Однако предсказания токенов дополнения следует исключить из вычисления функции потерь. Для этого мы можем замаскировать неважные элементы нулевыми значениями, чтобы произведение любого неважного предсказания на ноль давало ноль.
@d2l.add_to_class(Seq2Seq)
def loss(self, Y_hat, Y):
    l = super(Seq2Seq, self).loss(Y_hat, Y, averaged=False)
    mask = (Y.reshape(-1) != self.tgt_pad).type(torch.float32)
    return (l * mask).sum() / mask.sum()
10.7.6. Обучение
Теперь мы можем создать и обучить модель кодировщик–декодировщик на базе RNN для обучения последовательность-в-последовательность на наборе данных машинного перевода.
data = d2l.MTFraEng(batch_size=128)
embed_size, num_hiddens, num_layers, dropout = 256, 256, 2, 0.2
encoder = Seq2SeqEncoder(
    len(data.src_vocab), embed_size, num_hiddens, num_layers, dropout)
decoder = Seq2SeqDecoder(
    len(data.tgt_vocab), embed_size, num_hiddens, num_layers, dropout)
model = Seq2Seq(encoder, decoder, tgt_pad=data.tgt_vocab['<pad>'],
                lr=0.005)
trainer = d2l.Trainer(max_epochs=30, gradient_clip_val=1, num_gpus=1)
trainer.fit(model, data)
10.7.7. Предсказание
Для предсказания выходной последовательности на каждом шаге предсказанный токен с предыдущего временного шага подается на вход декодировщика. Одна из простых стратегий заключается в том, чтобы на каждом шаге выбирать тот токен, которому декодировщик присвоил наибольшую вероятность. Как и при обучении, на начальном временном шаге в декодировщик подается токен начала последовательности («<bos>»). Этот процесс предсказания проиллюстрирован на рисунке Fig. 10.7.3. Когда предсказывается токен конца последовательности («<eos>»), предсказание выходной последовательности завершается.
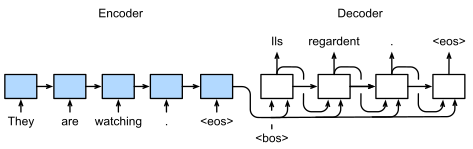
Fig. 10.7.3 Предсказание выходной последовательности по одному токену с использованием кодировщика–декодировщика на основе RNN.
В следующем разделе мы представим более сложные стратегии, основанные на лучевом поиске (Section 10.8).
@d2l.add_to_class(d2l.EncoderDecoder)  #@save
def predict_step(self, batch, device, num_steps,
                 save_attention_weights=False):
    batch = [a.to(device) for a in batch]
    src, tgt, src_valid_len, _ = batch
    enc_all_outputs = self.encoder(src, src_valid_len)
    dec_state = self.decoder.init_state(enc_all_outputs, src_valid_len)
    outputs, attention_weights = [tgt[:, 0].unsqueeze(1), ], []
    for _ in range(num_steps):
        Y, dec_state = self.decoder(outputs[-1], dec_state)
        outputs.append(Y.argmax(2))
        # Save attention weights (to be covered later)
        if save_attention_weights:
            attention_weights.append(self.decoder.attention_weights)
    return torch.cat(outputs[1:], 1), attention_weights
10.7.8. Оценка предсказанных последовательностей
Мы можем оценить предсказанную последовательность, сравнив её с целевой последовательностью (истинной). Но что именно является подходящей мерой для сравнения сходства между двумя последовательностями?
Bilingual Evaluation Understudy (BLEU), хотя изначально был предложен для оценки результатов машинного перевода (Papineni et al., 2002), широко применяется для измерения качества выходных последовательностей в различных приложениях. По сути, для любого \(n\)-грамма (Section 9.3.1.1) в предсказанной последовательности BLEU проверяет, присутствует ли этот \(n\)-грамм в целевой последовательности.
Denote by \(p_n\) the precision of an \(n\)-gram, defined as the ratio of the number of matched \(n\)-grams in the predicted and target sequences to the number of \(n\)-grams in the predicted sequence. To explain, given a target sequence \(A\), \(B\), \(C\), \(D\), \(E\), \(F\), and a predicted sequence \(A\), \(B\), \(B\), \(C\), \(D\), we have \(p_1 = 4/5\), \(p_2 = 3/4\), \(p_3 = 1/3\), and \(p_4 = 0\). Now let \(\textrm{len}_{\textrm{label}}\) and \(\textrm{len}_{\textrm{pred}}\) be the numbers of tokens in the target sequence and the predicted sequence, respectively. Then, BLEU is defined as
где \(k\) — это самый длинный \(n\)-грамм для сопоставления.
Согласно определению BLEU в (10.7.4), если предсказанная последовательность совпадает с целевой, значение BLEU равно 1. Кроме того, поскольку совпадение более длинных \(n\)-грамм достигается сложнее, BLEU присваивает больший вес, когда более длинная \(n\)-грамма имеет высокую точность. В частности, при фиксированном \(p_n\) величина \(p_n^{1/2^n}\) возрастает по мере увеличения \(n\) (в оригинальной статье используется \(p_n^{1/n}\)). Кроме того, поскольку предсказание более коротких последовательностей обычно приводит к более высокому значению \(p_n\), коэффициент перед множителем в (10.7.4) штрафует за предсказание слишком коротких последовательностей. Например, при \(k=2\), если целевая последовательность имеет вид \(A\), \(B\), \(C\), \(D\), \(E\), \(F\), а предсказанная — \(A\), \(B\), то, несмотря на то что \(p_1 = p_2 = 1\), штрафной множитель \(\exp(1-6/2) \approx 0.14\) снижает значение BLEU.
Мы реализуем метрику BLEU следующим образом.
def bleu(pred_seq, label_seq, k):  #@save
    """Compute the BLEU."""
    pred_tokens, label_tokens = pred_seq.split(' '), label_seq.split(' ')
    len_pred, len_label = len(pred_tokens), len(label_tokens)
    score = math.exp(min(0, 1 - len_label / len_pred))
    for n in range(1, min(k, len_pred) + 1):
        num_matches, label_subs = 0, collections.defaultdict(int)
        for i in range(len_label - n + 1):
            label_subs[' '.join(label_tokens[i: i + n])] += 1
        for i in range(len_pred - n + 1):
            if label_subs[' '.join(pred_tokens[i: i + n])] > 0:
                num_matches += 1
                label_subs[' '.join(pred_tokens[i: i + n])] -= 1
        score *= math.pow(num_matches / (len_pred - n + 1), math.pow(0.5, n))
    return score
В итоге мы используем обученный RNN-кодировщик–декодировщик, чтобы перевести несколько английских предложений на французский, и вычисляем BLEU полученных результатов.
engs = ['go .', 'i lost .', 'he\'s calm .', 'i\'m home .']
fras = ['va !', 'j\'ai perdu .', 'il est calme .', 'je suis chez moi .']
preds, _ = model.predict_step(
    data.build(engs, fras), d2l.try_gpu(), data.num_steps)
for en, fr, p in zip(engs, fras, preds):
    translation = []
    for token in data.tgt_vocab.to_tokens(p):
        if token == '<eos>':
            break
        translation.append(token)
    print(f'{en} => {translation}, bleu,'
          f'{bleu(" ".join(translation), fr, k=2):.3f}')
10.7.9. Итоги
Следуя архитектуре кодировщик–декодировщик, мы можем использовать две рекуррентные нейронные сети для построения модели обучения последовательность–в–последовательность. При обучении кодировщик–декодировщик подход teacher forcing подает в декодировщик исходные выходные последовательности (в отличие от предсказаний). При реализации кодировщика и декодировщика мы можем использовать многослойные рекуррентные нейронные сети. Мы можем использовать маски для фильтрации нерелевантных вычислений, например, при расчёте функции потерь. Для оценки выходных последовательностей популярной метрикой является BLEU, которая сопоставляет \(n\)-граммы между предсказанной последовательностью и целевой последовательностью.
10.7.10. Упражнения
Можно ли настроить гиперпараметры, чтобы улучшить результаты перевода?
Повторите эксперимент, не используя маски при вычислении функции потерь. Какие результаты вы наблюдаете? Почему?
Если кодировщик и декодировщик различаются по количеству слоёв или количеству скрытых единиц, как следует инициализировать скрытое состояние декодировщика?
При обучении замените принудительную подачу учителя на подачу предсказания предыдущего временного шага в декодировщик. Как это влияет на качество модели?
Повторите эксперимент, заменив GRU на LSTM.
Существуют ли другие способы проектирования выходного слоя декодировщика?