
11.7. Архитектура трансформера
Мы сравнивали свёрточные нейронные сети (CNN), рекуррентные нейронные сети (RNN) и самовнимание в Section 11.6.2. Примечательно, что самовнимание обеспечивает как параллельные вычисления, так и кратчайшую максимальную длину пути. Поэтому привлекательно конструировать глубокие архитектуры, использующие самовнимание. В отличие от более ранних моделей самовнимания, которые всё ещё опирались на RNN для формирования входных представлений (Cheng et al., 2016, Lin et al., 2017, Paulus et al., 2017), модель трансформер полностью основана на механизмах внимания и не содержит ни свёрточных, ни рекуррентных слоёв (Vaswani et al., 2017). Хотя изначально трансформеры были предложены для обучения преобразованию последовательностей в последовательности на текстовых данных, они стали широко применяться в самых разных современных задачах глубокого обучения, включая области, связанные с языком, зрением, речью и обучением с подкреплением.
import math
import pandas as pd
import torch
from torch import nn
from d2l import torch as d2l
11.7.1. Модель
В качестве примера архитектуры кодировщик–декодировщик общая структура трансформера представлена на рисунке Fig. 11.7.1. Как видно, трансформер состоит из кодировщика и декодировщика. В отличие от внимания Бахдану для обучения преобразованию последовательностей в Fig. 11.4.2, входные (исходные) и выходные (целевые) эмбеддинги последовательностей суммируются с позиционным кодированием перед подачей в кодировщик и декодировщик, которые состоят из модулей, основанных на самовнимании.
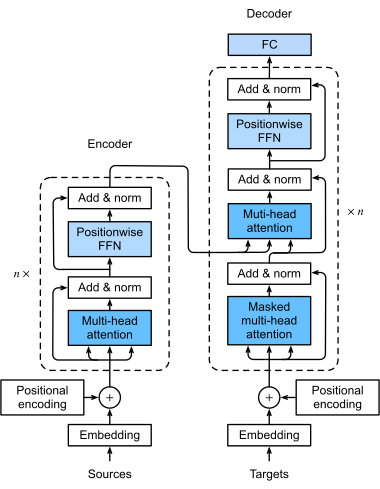
Fig. 11.7.1 Архитектура трансформера.
Теперь мы приводим обзор архитектуры трансформера в Fig. 11.7.1. На высоком уровне кодировщик трансформера представляет собой стек из нескольких идентичных слоёв, каждый из которых содержит два подслоя (обозначенных как \(\textrm{sublayer}\)). Первый — это агрегирование по вниманию с несколькими головами (multi-head self-attention pooling), а второй — позиционно-независимая полносвязная сеть. В частности, в самовнимание кодировщика запросы, ключи и значения берутся из выходов предыдущего слоя кодировщика. Вдохновлённые архитектурой ResNet из Section 8.6, мы используем остаточную связь вокруг обоих подслоёв. В трансформере для любого входа \(\mathbf{x} \in \mathbb{R}^d\) на любой позиции последовательности мы требуем, чтобы \(\textrm{sublayer}(\mathbf{x}) \in \mathbb{R}^d\), что делает возможной остаточную связь \(\mathbf{x} + \textrm{sublayer}(\mathbf{x}) \in \mathbb{R}^d\). К результату сложения от остаточной связи сразу применяется нормализация слоя (Ba et al., 2016). В результате кодировщик трансформера выдаёт векторное представление размерности \(d\) для каждой позиции входной последовательности.
Декодер трансформера также представляет собой стек из нескольких идентичных слоёв с остаточными связями и нормализацией по слоям. Помимо двух подслоёв, описанных в кодировщике, декодер вставляет между ними третий подслой, известный как внимание кодировщика–декодера. В внимании кодировщика–декодера запросы берутся из выходов подслойного самовнимания декодера, а ключи и значения — из выходов кодировщика трансформера. В самовнимании декодера запросы, ключи и значения берутся из выходов предыдущего слоя декодера. Однако каждая позиция в декодере может обращаться только ко всем позициям вплоть до этой позиции включительно. Это замаскированное внимание сохраняет авторегрессионное свойство, гарантируя, что предсказание зависит только от тех выходных токенов, которые уже были сгенерированы.
Мы уже описали и реализовали многоголовое внимание на основе взвешенных скалярных произведений в Section 11.5 и позиционное кодирование в Section 11.6.3. В дальнейшем мы реализуем остальные компоненты трансформера.
11.7.2. Позиционно-независимые сети прямого распространения
Позиционно-ориентированная сеть прямого распространения преобразует
представления во всех позициях последовательности с помощью одного и
того же многослойного перцептрона (MLP). Именно поэтому мы называем её
позиционно-ориентированной. В приведённой ниже реализации входной
тензор X формы (размер батча, количество временных шагов или длина
последовательности в токенах, количество скрытых единиц или размерность
признака) преобразуется двухслойным MLP в выходной тензор формы (размер
батча, количество временных шагов, ffn_num_outputs).
class PositionWiseFFN(nn.Module):  #@save
    """The positionwise feed-forward network."""
    def __init__(self, ffn_num_hiddens, ffn_num_outputs):
        super().__init__()
        self.dense1 = nn.LazyLinear(ffn_num_hiddens)
        self.relu = nn.ReLU()
        self.dense2 = nn.LazyLinear(ffn_num_outputs)

    def forward(self, X):
        return self.dense2(self.relu(self.dense1(X)))
В следующем примере показано, что внутренняя размерность тензора изменяется на число выходов в позиционной сети прямого распространения. Поскольку одна и та же сеть MLP применяется на всех позициях, при одинаковых входах на всех этих позициях выходные данные также будут идентичными.
ffn = PositionWiseFFN(4, 8)
ffn.eval()
ffn(torch.ones((2, 3, 4)))[0]
11.7.3. Остаточная связь и нормализация слоя
Теперь сосредоточимся на компоненте «add & norm» в Fig. 11.7.1. Как мы указали в начале этого раздела, это остаточная связь, за которой сразу следует нормализация слоя. Оба механизма являются ключевыми для эффективных глубоких архитектур.
В Section 8.5 мы объяснили, как батч-нормализация центрирует и масштабирует данные по примерам внутри мини-батча. Как обсуждалось в Section 8.5.2.3, нормализация слоя аналогична батч-нормализации, за исключением того, что она выполняется по размерности признаков, что обеспечивает независимость от масштаба и размера батча. Несмотря на широкое применение в компьютерном зрении, батч-нормализация обычно оказывается менее эффективной, чем нормализация слоя, в задачах обработки естественного языка, где входные данные часто представляют собой последовательности переменной длины.
В следующем фрагменте кода сравнивается нормализация по различным размерностям с помощью нормализации слоя и батч-нормализации.
ln = nn.LayerNorm(2)
bn = nn.LazyBatchNorm1d()
X = torch.tensor([[1, 2], [2, 3]], dtype=torch.float32)
# Compute mean and variance from X in the training mode
print('layer norm:', ln(X), '\nbatch norm:', bn(X))
Теперь мы можем реализовать класс AddNorm с использованием
остаточной связи, за которой следует нормализация слоя. Для
регуляризации также применяется дропаут.
class AddNorm(nn.Module):  #@save
    """The residual connection followed by layer normalization."""
    def __init__(self, norm_shape, dropout):
        super().__init__()
        self.dropout = nn.Dropout(dropout)
        self.ln = nn.LayerNorm(norm_shape)

    def forward(self, X, Y):
        return self.ln(self.dropout(Y) + X)
Остаточная связь требует, чтобы оба входа имели одинаковую форму, так как тензор вывода также будет иметь ту же форму после операции сложения.
add_norm = AddNorm(4, 0.5)
shape = (2, 3, 4)
d2l.check_shape(add_norm(torch.ones(shape), torch.ones(shape)), shape)
11.7.4. Кодировщик
Имея все необходимые компоненты для сборки кодировщика трансформера,
начнем с реализации одного слоя кодировщика. Приведённый ниже
TransformerEncoderBlock класс содержит два подслоя: многоголовое
самовнимание и позиционно-независимые сети прямого распространения, в
которых вокруг обоих подслоев применяется остаточная связь с последующей
нормализацией слоя.
class TransformerEncoderBlock(nn.Module):  #@save
    """The Transformer encoder block."""
    def __init__(self, num_hiddens, ffn_num_hiddens, num_heads, dropout,
                 use_bias=False):
        super().__init__()
        self.attention = d2l.MultiHeadAttention(num_hiddens, num_heads,
                                                dropout, use_bias)
        self.addnorm1 = AddNorm(num_hiddens, dropout)
        self.ffn = PositionWiseFFN(ffn_num_hiddens, num_hiddens)
        self.addnorm2 = AddNorm(num_hiddens, dropout)

    def forward(self, X, valid_lens):
        Y = self.addnorm1(X, self.attention(X, X, X, valid_lens))
        return self.addnorm2(Y, self.ffn(Y))
Как мы видим, ни один слой в кодировщике трансформера не изменяет форму своего входа.
X = torch.ones((2, 100, 24))
valid_lens = torch.tensor([3, 2])
encoder_blk = TransformerEncoderBlock(24, 48, 8, 0.5)
encoder_blk.eval()
d2l.check_shape(encoder_blk(X, valid_lens), X.shape)
В следующей реализации [кодировщика трансформера] мы используем
num_blks экземпляров вышеописанных TransformerEncoderBlock
классов. Поскольку мы применяем фиксированное позиционное кодирование,
значения которого всегда находятся в диапазоне от \(-1\) до
\(1\), мы умножаем значения обучаемых входных эмбеддингов на
квадратный корень из размерности эмбеддинга, чтобы масштабировать их
перед сложением входного эмбеддинга и позиционного кодирования.
class TransformerEncoder(d2l.Encoder):  #@save
    """The Transformer encoder."""
    def __init__(self, vocab_size, num_hiddens, ffn_num_hiddens,
                 num_heads, num_blks, dropout, use_bias=False):
        super().__init__()
        self.num_hiddens = num_hiddens
        self.embedding = nn.Embedding(vocab_size, num_hiddens)
        self.pos_encoding = d2l.PositionalEncoding(num_hiddens, dropout)
        self.blks = nn.Sequential()
        for i in range(num_blks):
            self.blks.add_module("block"+str(i), TransformerEncoderBlock(
                num_hiddens, ffn_num_hiddens, num_heads, dropout, use_bias))

    def forward(self, X, valid_lens):
        # Since positional encoding values are between -1 and 1, the embedding
        # values are multiplied by the square root of the embedding dimension
        # to rescale before they are summed up
        X = self.pos_encoding(self.embedding(X) * math.sqrt(self.num_hiddens))
        self.attention_weights = [None] * len(self.blks)
        for i, blk in enumerate(self.blks):
            X = blk(X, valid_lens)
            self.attention_weights[
                i] = blk.attention.attention.attention_weights
        return X
Ниже мы зададим гиперпараметры для создания двухслойного кодировщика
трансформера. Форма вывода кодировщика трансформера равна (размер батча,
количество временных шагов, num_hiddens).
encoder = TransformerEncoder(200, 24, 48, 8, 2, 0.5)
d2l.check_shape(encoder(torch.ones((2, 100), dtype=torch.long), valid_lens),
                (2, 100, 24))
11.7.5. Декодировщик
Как показано в Fig. 11.7.1, декодировщик трансформера
состоит из нескольких идентичных слоёв. Каждый слой реализован в
следующем TransformerDecoderBlock классе и содержит три подслоя:
самовнимание декодировщика, внимание между кодировщиком и декодировщиком
и позиционно-свёрточные сети. Вокруг этих подслоев применяется
остаточная связь, за которой следует нормализация слоя.
Как описывалось ранее в этом разделе, в маскированном многоголовом
самовнимании декодировщика (первом подслойном блоке) запросы, ключи и
значения берутся из выходов предыдущего слоя декодировщика. При обучении
моделей преобразования последовательностей в последовательности все
токены на всех позициях (шагах времени) выходной последовательности
известны. Однако во время предсказания выходная последовательность
генерируется токеном за токеном; следовательно, на любом шаге времени
декодировщика в самовнимании декодировщика могут использоваться только
уже сгенерированные токены. Чтобы сохранить авторегрессионность
декодировщика, его маскированное самовнимание задаётся так
dec_valid_lens, что любой запрос обращает внимание только на все
позиции в декодировщике вплоть до позиции самого запроса.
class TransformerDecoderBlock(nn.Module):
    # The i-th block in the Transformer decoder
    def __init__(self, num_hiddens, ffn_num_hiddens, num_heads, dropout, i):
        super().__init__()
        self.i = i
        self.attention1 = d2l.MultiHeadAttention(num_hiddens, num_heads,
                                                 dropout)
        self.addnorm1 = AddNorm(num_hiddens, dropout)
        self.attention2 = d2l.MultiHeadAttention(num_hiddens, num_heads,
                                                 dropout)
        self.addnorm2 = AddNorm(num_hiddens, dropout)
        self.ffn = PositionWiseFFN(ffn_num_hiddens, num_hiddens)
        self.addnorm3 = AddNorm(num_hiddens, dropout)

    def forward(self, X, state):
        enc_outputs, enc_valid_lens = state[0], state[1]
        # During training, all the tokens of any output sequence are processed
        # at the same time, so state[2][self.i] is None as initialized. When
        # decoding any output sequence token by token during prediction,
        # state[2][self.i] contains representations of the decoded output at
        # the i-th block up to the current time step
        if state[2][self.i] is None:
            key_values = X
        else:
            key_values = torch.cat((state[2][self.i], X), dim=1)
        state[2][self.i] = key_values
        if self.training:
            batch_size, num_steps, _ = X.shape
            # Shape of dec_valid_lens: (batch_size, num_steps), where every
            # row is [1, 2, ..., num_steps]
            dec_valid_lens = torch.arange(
                1, num_steps + 1, device=X.device).repeat(batch_size, 1)
        else:
            dec_valid_lens = None
        # Self-attention
        X2 = self.attention1(X, key_values, key_values, dec_valid_lens)
        Y = self.addnorm1(X, X2)
        # Encoder-decoder attention. Shape of enc_outputs:
        # (batch_size, num_steps, num_hiddens)
        Y2 = self.attention2(Y, enc_outputs, enc_outputs, enc_valid_lens)
        Z = self.addnorm2(Y, Y2)
        return self.addnorm3(Z, self.ffn(Z)), state
Для обеспечения возможности выполнения операций скалярного произведения с масштабированием в механизме внимания между кодировщиком и декодировщиком, а также операций сложения в остаточных связях, размерность признаков (``num_hiddens``) декодировщика совпадает с размерностью признаков кодировщика.
decoder_blk = TransformerDecoderBlock(24, 48, 8, 0.5, 0)
X = torch.ones((2, 100, 24))
state = [encoder_blk(X, valid_lens), valid_lens, [None]]
d2l.check_shape(decoder_blk(X, state)[0], X.shape)
Теперь мы построим весь декодировщик трансформера, состоящий из
num_blks экземпляров TransformerDecoderBlock. В конце
полносвязный слой вычисляет предсказание для всех vocab_size
возможных выходных токенов. Как веса самовнимания декодировщика, так и
веса внимания между кодировщиком и декодировщиком сохраняются для
последующей визуализации.
class TransformerDecoder(d2l.AttentionDecoder):
    def __init__(self, vocab_size, num_hiddens, ffn_num_hiddens, num_heads,
                 num_blks, dropout):
        super().__init__()
        self.num_hiddens = num_hiddens
        self.num_blks = num_blks
        self.embedding = nn.Embedding(vocab_size, num_hiddens)
        self.pos_encoding = d2l.PositionalEncoding(num_hiddens, dropout)
        self.blks = nn.Sequential()
        for i in range(num_blks):
            self.blks.add_module("block"+str(i), TransformerDecoderBlock(
                num_hiddens, ffn_num_hiddens, num_heads, dropout, i))
        self.dense = nn.LazyLinear(vocab_size)

    def init_state(self, enc_outputs, enc_valid_lens):
        return [enc_outputs, enc_valid_lens, [None] * self.num_blks]

    def forward(self, X, state):
        X = self.pos_encoding(self.embedding(X) * math.sqrt(self.num_hiddens))
        self._attention_weights = [[None] * len(self.blks) for _ in range (2)]
        for i, blk in enumerate(self.blks):
            X, state = blk(X, state)
            # Decoder self-attention weights
            self._attention_weights[0][
                i] = blk.attention1.attention.attention_weights
            # Encoder-decoder attention weights
            self._attention_weights[1][
                i] = blk.attention2.attention.attention_weights
        return self.dense(X), state

    @property
    def attention_weights(self):
        return self._attention_weights
11.7.6. Обучение
Давайте реализуем модель «кодировщик–декодировщик» в соответствии с архитектурой трансформера. Здесь мы указываем, что как кодировщик, так и декодировщик на основе трансформера состоят из двух слоёв с многоголовым вниманием (4 головы). Как и в Section 10.7.6, мы обучаем модель трансформера для задач машинного перевода «последовательность в последовательность» на наборе данных машинного перевода с английского на французский язык.
data = d2l.MTFraEng(batch_size=128)
num_hiddens, num_blks, dropout = 256, 2, 0.2
ffn_num_hiddens, num_heads = 64, 4
encoder = TransformerEncoder(
    len(data.src_vocab), num_hiddens, ffn_num_hiddens, num_heads,
    num_blks, dropout)
decoder = TransformerDecoder(
    len(data.tgt_vocab), num_hiddens, ffn_num_hiddens, num_heads,
    num_blks, dropout)
model = d2l.Seq2Seq(encoder, decoder, tgt_pad=data.tgt_vocab['<pad>'],
                    lr=0.001)
trainer = d2l.Trainer(max_epochs=30, gradient_clip_val=1, num_gpus=1)
trainer.fit(model, data)
После обучения мы используем модель трансформер для перевода нескольких английских предложений на французский язык и вычисления их оценок BLEU.
engs = ['go .', 'i lost .', 'he\'s calm .', 'i\'m home .']
fras = ['va !', 'j\'ai perdu .', 'il est calme .', 'je suis chez moi .']
preds, _ = model.predict_step(
    data.build(engs, fras), d2l.try_gpu(), data.num_steps)
for en, fr, p in zip(engs, fras, preds):
    translation = []
    for token in data.tgt_vocab.to_tokens(p):
        if token == '<eos>':
            break
        translation.append(token)
    print(f'{en} => {translation}, bleu,'
          f'{d2l.bleu(" ".join(translation), fr, k=2):.3f}')
Давайте визуализируем веса внимания трансформера при переводе последнего
английского предложения на французский. Форма весов самовнимания
кодировщика равна (число слоёв кодировщика, число голов внимания,
num_steps или число запросов, num_steps или число пар
ключ-значение).
_, dec_attention_weights = model.predict_step(
    data.build([engs[-1]], [fras[-1]]), d2l.try_gpu(), data.num_steps, True)
enc_attention_weights = torch.cat(model.encoder.attention_weights, 0)
shape = (num_blks, num_heads, -1, data.num_steps)
enc_attention_weights = enc_attention_weights.reshape(shape)
d2l.check_shape(enc_attention_weights,
                (num_blks, num_heads, data.num_steps, data.num_steps))
В самовнимании кодировщика и запросы, и ключи поступают из одной и той же входной последовательности. Поскольку токены дополнения не несут смысловой нагрузки, при заданной допустимой длине входной последовательности ни один запрос не обращает внимания на позиции токенов дополнения. Ниже построчно представлены веса многоголовного внимания двух слоёв. Каждая голова независимо формирует внимание на основе отдельного подпространства представлений запросов, ключей и значений.
d2l.show_heatmaps(
    enc_attention_weights.cpu(), xlabel='Key positions',
    ylabel='Query positions', titles=['Head %d' % i for i in range(1, 5)],
    figsize=(7, 3.5))
Чтобы визуализировать веса самовнимания декодировщика и веса внимания между кодировщиком и декодировщиком, нам потребуются дополнительные манипуляции с данными. Например, мы заменяем замаскированные веса внимания нулями. Обратите внимание, что в весах самовнимания декодировщика и в весах внимания между кодировщиком и декодировщиком используются одни и те же запросы: токен начала последовательности, за которым следуют выходные токены и, возможно, токены конца последовательности.
dec_attention_weights_2d = [head[0].tolist()
                            for step in dec_attention_weights
                            for attn in step for blk in attn for head in blk]
dec_attention_weights_filled = torch.tensor(
    pd.DataFrame(dec_attention_weights_2d).fillna(0.0).values)
shape = (-1, 2, num_blks, num_heads, data.num_steps)
dec_attention_weights = dec_attention_weights_filled.reshape(shape)
dec_self_attention_weights, dec_inter_attention_weights = \
    dec_attention_weights.permute(1, 2, 3, 0, 4)
d2l.check_shape(dec_self_attention_weights,
                (num_blks, num_heads, data.num_steps, data.num_steps))
d2l.check_shape(dec_inter_attention_weights,
                (num_blks, num_heads, data.num_steps, data.num_steps))
Благодаря авторегрессионному свойству самовнимания декодировщика ни один запрос не обращает внимания на пары ключ–значение, следующие за позицией этого запроса.
d2l.show_heatmaps(
    dec_self_attention_weights[:, :, :, :],
    xlabel='Key positions', ylabel='Query positions',
    titles=['Head %d' % i for i in range(1, 5)], figsize=(7, 3.5))
Как и в случае с самовниманием в кодировщике, с помощью указанного допустимого размера входной последовательности ни один запрос из выходной последовательности не обращает внимания на токены дополнения входной последовательности.
d2l.show_heatmaps(
    dec_inter_attention_weights, xlabel='Key positions',
    ylabel='Query positions', titles=['Head %d' % i for i in range(1, 5)],
    figsize=(7, 3.5))
Хотя архитектура трансформера изначально была предложена для обучения преобразованию последовательности в последовательность, как мы увидим далее в книге, кодировщик или декодировщик трансформера часто используются по отдельности для решения различных задач глубокого обучения.
11.7.7. Итоги
Трансформер представляет собой объект архитектуры кодировщик–декодировщик, хотя на практике кодировщик или декодировщик могут использоваться по отдельности. В архитектуре трансформера для представления входной и выходной последовательностей используется многоголовое самовнимание, при этом декодировщик должен сохранять авторегрессионное свойство с помощью маскированной версии. И остаточные связи, и нормализация слоя в трансформере важны для обучения очень глубокой модели. Позиционно-независимая полносвязная сеть в модели трансформера преобразует представление во всех позициях последовательности с помощью одного и того же многослойного перцептрона.
11.7.8. Упражнения
Проведите эксперименты с более глубоким трансформером. Как это влияет на скорость обучения и качество перевода?
Является ли хорошей идеей заменить взвешенное по масштабу скалярное произведение в механизме внимания на аддитивное внимание в трансформере? Почему?
Для языкового моделирования следует использовать кодировщик трансформера, декодировщик или оба? Как бы вы спроектировали этот метод?
Какие проблемы могут возникнуть у трансформеров при работе с очень длинными входными последовательностями? Почему?
Как можно повысить вычислительную эффективность и эффективность использования памяти в архитектуре Transformer? Подсказка: см. обзорную статью Tay et al. (2020).