
11.1. Запросы, ключи и значения
До сих пор все рассмотренные нами сети критически зависели от того, что входные данные имеют строго определённый размер. Например, изображения в наборе данных ImageNet имеют размер \(224 \times 224\) пикселей, а свёрточные нейронные сети (CNN) специально настроены именно на этот размер. Даже в задачах обработки естественного языка размер входа для рекуррентных нейронных сетей (RNN) строго определён и фиксирован. Переменную длину входных данных решают путём последовательной обработки одного токена за раз или с помощью специально разработанных свёрточных ядер (Kalchbrenner et al., 2014). Такой подход может привести к серьёзным проблемам, когда входные данные действительно имеют переменный размер и различное информационное содержание, как это происходит, например, в Section 10.7 при преобразовании текста (Sutskever et al., 2014). В частности, для длинных последовательностей становится довольно сложно отслеживать всё, что уже было сгенерировано или просмотрено сетью. Даже такие эвристики явного отслеживания, как предложенные в Yang et al. (2016), дают лишь ограниченный эффект.
Сравните это с базами данных. В своей простейшей форме они представляют собой наборы ключей (\(k\)) и значений (\(v\)). Например, наша база данных \(\mathcal{D}\) может состоять из кортежей {(“Zhang”, “Aston”), (“Lipton”, “Zachary”), (“Li”, “Mu”), (“Smola”, “Alex”), (“Hu”, “Rachel”), (“Werness”, “Brent”)}, где фамилия является ключом, а имя — значением. Мы можем выполнять операции над \(\mathcal{D}\), например, используя точный запрос (\(q\)) к «Li», который вернёт значение «Mu». Если бы кортежа (“Li”, “Mu”) не было в \(\mathcal{D}\), корректного ответа не существовало бы. Если бы мы также допускали приблизительные совпадения, мы бы получили (“Lipton”, “Zachary”). Этот довольно простой и тривиальный пример, тем не менее, учит нас нескольким полезным вещам:
Мы можем спроектировать запросы \(q\), которые работают с парами (\(k\), \(v\)) таким образом, чтобы они оставались корректными независимо от размера базы данных.
Один и тот же запрос может получать разные ответы в зависимости от содержимого базы данных.
«Код», выполняемый для обработки большого пространства состояний (базы данных), может быть довольно простым (например, точное совпадение, приближённое совпадение, топ-\(k\)).
Нет необходимости сжимать или упрощать базу данных, чтобы операции были эффективными.
Очевидно, мы ввели простую базу данных не просто так, а с целью объяснения глубокого обучения. Действительно, это приводит к одному из самых важных понятий, появившихся в глубоком обучении за последнее десятилетие: механизму внимания (Bahdanau et al., 2014). Мы рассмотрим особенности его применения к машинному переводу позже. А пока просто рассмотрим следующее: обозначим через \(\mathcal{D} \stackrel{\textrm{def}}{=} \{(\mathbf{k}_1, \mathbf{v}_1), \ldots (\mathbf{k}_m, \mathbf{v}_m)\}\) базу данных кортежей \(m\), состоящих из ключей и значений. Кроме того, обозначим через \(\mathbf{q}\) запрос. Тогда мы можем определить внимание по отношению к \(\mathcal{D}\) как
где \(\alpha(\mathbf{q}, \mathbf{k}_i) \in \mathbb{R}\) (\(i = 1, \ldots, m\)) — скалярные веса внимания. Сама операция обычно называется агрегированием по вниманию. Название «внимание» происходит от того, что операция уделяет особое внимание тем членам, для которых вес \(\alpha\) значим (т. е. велик). Таким образом, внимание над \(\mathcal{D}\) порождает линейную комбинацию значений, содержащихся в базе данных. Фактически, это содержит вышеупомянутый пример как частный случай, когда все веса, кроме одного, равны нулю. Рассмотрим ряд частных случаев:
Веса \(\alpha(\mathbf{q}, \mathbf{k}_i)\) неотрицательны. В этом случае выход механизма внимания принадлежит выпуклому конусу, натянутому на значения \(\mathbf{v}_i\).
Веса \(\alpha(\mathbf{q}, \mathbf{k}_i)\) образуют выпуклую комбинацию, то есть \(\sum_i \alpha(\mathbf{q}, \mathbf{k}_i) = 1\) и \(\alpha(\mathbf{q}, \mathbf{k}_i) \geq 0\) для всех \(i\). Это наиболее распространённый режим в глубоком обучении.
Ровно один из весов \(\alpha(\mathbf{q}, \mathbf{k}_i)\) равен \(1\), а все остальные равны \(0\). Это аналогично традиционному запросу к базе данных.
Все веса равны, то есть \(\alpha(\mathbf{q}, \mathbf{k}_i) = \frac{1}{m}\) для всех \(i\). Это эквивалентно усреднению по всей базе данных, что также называется средним пулингом в глубоком обучении.
Общей стратегией обеспечения того, чтобы веса суммировались до \(1\), является их нормализация с помощью
В частности, чтобы гарантировать неотрицательность весов, можно воспользоваться экспоненцированием. Это означает, что теперь мы можем выбрать любую функцию \(a(\mathbf{q}, \mathbf{k})\), а затем применить к ней операцию софтмакс, используемую в мультиномиальных моделях, следующим образом:
Эта операция доступна во всех фреймворках глубокого обучения. Она дифференцируема, а её градиент никогда не обращается в ноль, что является желательным свойством модели. Однако следует отметить, что описанный выше механизм внимания — не единственный вариант. Например, можно разработать недифференцируемую модель внимания, которую можно обучать методами обучения с подкреплением (Mnih et al., 2014). Как и следовало ожидать, обучение такой модели довольно сложно. В результате большая часть современных исследований в области внимания следует подходу, изложенному в Fig. 11.1.1. Поэтому мы сосредоточимся на этом семействе дифференцируемых механизмов.
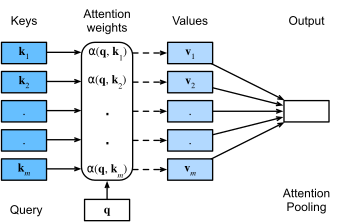
Fig. 11.1.1 Механизм внимания вычисляет линейную комбинацию значений \(\mathbf{v}_\mathit{i}\) с помощью агрегирования по вниманию, где веса определяются на основе совместимости между запросом \(\mathbf{q}\) и ключами \(\mathbf{k}_\mathit{i}\).
Что действительно примечательно, так это то, что сам «код» выполнения операций над множеством ключей и значений, а именно запрос, может быть весьма лаконичным, несмотря на значительный объём пространства, с которым приходится работать. Это желательное свойство для слоя сети, поскольку оно не требует обучения большого количества параметров. Также удобно то, что внимание может работать с базами данных произвольного размера без необходимости изменения способа выполнения операции агрегирования по вниманию.
import torch
from d2l import torch as d2l
11.1.1. Визуализация
Одним из преимуществ механизма внимания является его интуитивная понятность, особенно когда веса неотрицательны и в сумме дают \(1\). В этом случае мы можем интерпретировать большие веса как способ модели отбирать значимые компоненты. Хотя это здравая интуиция, важно помнить, что это всё же лишь интуиция. Тем не менее, мы можем захотеть визуализировать его влияние на заданный набор ключей при применении различных запросов. Эта функция пригодится нам позже.
Таким образом, мы определяем функцию show_heatmaps. Обратите
внимание, что она принимает на вход не матрицу (весов внимания), а
тензор с четырьмя осями, что позволяет работать с массивом различных
запросов и весов. Следовательно, входной тензор matrices имеет форму
(число строк для отображения, число столбцов для отображения, число
запросов, число ключей). Это пригодится нам позже, когда мы захотим
визуализировать принципы работы, лежащие в основе архитектуры
Transformer.
#@save
def show_heatmaps(matrices, xlabel, ylabel, titles=None, figsize=(2.5, 2.5),
                  cmap='Reds'):
    """Show heatmaps of matrices."""
    d2l.use_svg_display()
    num_rows, num_cols, _, _ = matrices.shape
    fig, axes = d2l.plt.subplots(num_rows, num_cols, figsize=figsize,
                                 sharex=True, sharey=True, squeeze=False)
    for i, (row_axes, row_matrices) in enumerate(zip(axes, matrices)):
        for j, (ax, matrix) in enumerate(zip(row_axes, row_matrices)):
            pcm = ax.imshow(matrix.detach().numpy(), cmap=cmap)
            if i == num_rows - 1:
                ax.set_xlabel(xlabel)
            if j == 0:
                ax.set_ylabel(ylabel)
            if titles:
                ax.set_title(titles[j])
    fig.colorbar(pcm, ax=axes, shrink=0.6);
Для быстрой проверки визуализируем единичную матрицу, которая представляет случай, когда вес внимания равен \(1\) только тогда, когда запрос и ключ совпадают.
attention_weights = torch.eye(10).reshape((1, 1, 10, 10))
show_heatmaps(attention_weights, xlabel='Keys', ylabel='Queries')
11.1.2. Итоги
Механизм внимания позволяет агрегировать данные из множества пар (ключ, значение). До сих пор наше обсуждение было довольно абстрактным и сводилось лишь к описанию способа агрегации данных. Мы ещё не объяснили, откуда могут возникать эти загадочные запросы, ключи и значения. Здесь может помочь некоторая интуиция: например, в задаче регрессии запрос может соответствовать точке, в которой должна выполняться регрессия. Ключи — это точки, в которых были получены предыдущие данные, а значения — сами (регрессионные) значения. Это так называемый оценщик Надарая–Ватсона (Nadaraya, 1964, Watson, 1964), который мы будем изучать в следующем разделе.
По замыслу, механизм внимания обеспечивает дифференцируемый способ управления, с помощью которого нейронная сеть может выбирать элементы из множества и формировать соответствующую взвешенную сумму представлений.
11.1.3. Упражнения
Предположим, что вы хотите переписать приближённые совпадения (ключ, запрос), используемые в классических базах данных. Какую функцию внимания вы бы выбрали?
Предположим, что функция внимания задана выражением \(a(\mathbf{q}, \mathbf{k}_i) = \mathbf{q}^\top \mathbf{k}_i\) и что \(\mathbf{k}_i = \mathbf{v}_i\) для \(i = 1, \ldots, m\). Обозначим через \(p(\mathbf{k}_i; \mathbf{q})\) распределение вероятностей по ключам при использовании нормировки софтмакс в (11.1.3). Докажите, что \(\nabla_{\mathbf{q}} \mathop{\textrm{Attention}}(\mathbf{q}, \mathcal{D}) = \textrm{Cov}_{p(\mathbf{k}_i; \mathbf{q})}[\mathbf{k}_i]\).
Разработайте дифференцируемую поисковую систему на основе механизма внимания.
Рассмотрите архитектуру сетей Squeeze-and-Excitation (Hu et al., 2018) и интерпретируйте их с точки зрения механизма внимания.