
19.5. Асинхронное последовательное отсечение
Как мы видели в Section 19.3, мы можем ускорить поиск гиперпараметров (HPO), распределив оценку конфигураций гиперпараметров между несколькими объектами или несколькими процессорами/видеокартами на одном объекте. Однако, в отличие от случайного поиска, запустить последовательное усечение (SH) асинхронно в распределенной среде не так просто. Прежде чем решить, какую конфигурацию запустить следующей, нам необходимо собрать все наблюдения на текущем уровне. Это требует синхронизации рабочих узлов на каждом уровне. Например, для самого нижнего уровня \(r_{\mathrm{min}}\) нам сначала нужно оценить все \(N = \eta^K\) конфигураций, прежде чем мы сможем отобрать \(\frac{1}{\eta}\) из них для перехода на следующий уровень.
В любой распределённой системе синхронизация обычно приводит к простоям рабочих. Во-первых, мы часто наблюдаем значительные различия во времени обучения для различных конфигураций гиперпараметров. Например, если предположить, что количество фильтров на слой является гиперпараметром, то сети с меньшим количеством фильтров завершают обучение быстрее, чем сети с большим количеством фильтров, что приводит к простоям рабочих из-за медлительных узлов. Кроме того, количество слотов на уровне рунга не всегда кратно количеству рабочих, в результате чего некоторые из них могут простаивать целую партию.
На рисунке Fig. 19.5.1 показан процесс планирования синхронного SH с \(\eta=2\) для четырёх различных испытаний с использованием двух рабочих. Мы начинаем с оценки Trial-0 и Trial-1 в течение одной эпохи и сразу же переходим к следующим двум испытаниям, как только они завершатся. Сначала нам приходится ждать завершения Trial-2, что занимает значительно больше времени, чем другие испытания, прежде чем мы сможем перевести два лучших испытания, а именно Trial-0 и Trial-3, на следующий уровень. Это приводит к простоям Worker-1. Затем мы переходим к Rung 1. И здесь Trial-3 выполняется дольше, чем Trial-0, что вызывает дополнительный простой Worker-0. Как только мы достигаем Rung-2, остаётся только лучшее испытание, Trial-0, которое задействует лишь одного рабочего. Чтобы избежать простоя Worker-1 в этот период, большинство реализаций SH уже начинают следующий раунд и приступают к оценке новых испытаний (например, Trial-4) на первом уровне.
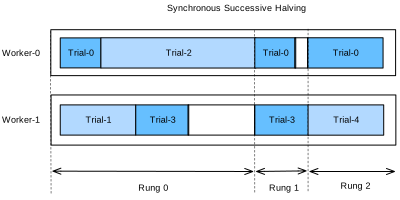
Fig. 19.5.1 Синхронный последовательный халвинг с двумя рабочими.
Асинхронный последовательный отсев (ASHA) (Li et al., 2018) адаптирует метод SH к асинхронной параллельной среде. Основная идея ASHA заключается в том, чтобы переводить конфигурации на следующий уровень, как только собрано как минимум \(\eta\) наблюдений на текущем уровне. Это правило может приводить к неоптимальным переводам: конфигурации переводятся на следующий уровень, хотя при более тщательном анализе оказывается, что они уступают большинству других конфигураций на том же уровне. С другой стороны, таким образом мы полностью избавляемся от точек синхронизации. На практике такие неоптимальные начальные переводы оказывают лишь незначительное влияние на производительность, не только потому, что ранжирование конфигураций гиперпараметров часто достаточно стабильно на разных уровнях, но и потому, что уровни со временем расширяются и всё лучше отражают распределение значений метрик на данном уровне. Если рабочий узел свободен, но переводить нечего, мы запускаем новую конфигурацию с \(r = r_{\mathrm{min}}\), то есть с первого уровня.
Fig. 19.5.2 показывает расписание тех же конфигураций для ASHA. Как только Trial-1 завершается, мы собираем результаты двух испытаний (т. е. Trial-0 и Trial-1) и немедленно переводим лучшее из них (Trial-0) на следующий рунг. После завершения Trial-0 на рунге 1 там слишком мало испытаний для дальнейшего перевода. Поэтому мы продолжаем работу на рунге 0 и оцениваем Trial-3. Как только Trial-3 завершается, Trial-2 всё ещё находится в ожидании. На этом этапе у нас есть 3 испытания, оценённые на рунге 0, и одно испытание, уже оценённое на рунге 1. Поскольку Trial-3 работает хуже, чем Trial-0 на рунге 0, и \(\eta=2\), мы не можем перевести ни одно новое испытание, и Worker-1 начинает Trial-4 с нуля. Однако, как только Trial-2 завершается и показывает результат хуже, чем Trial-3, последний переводится на рунг 1. После этого мы собрали 2 оценки на рунге 1, что позволяет теперь перевести Trial-0 на рунг 2. В то же время Worker-1 продолжает оценивать новые испытания (т. е. Trial-5) на рунге 0.
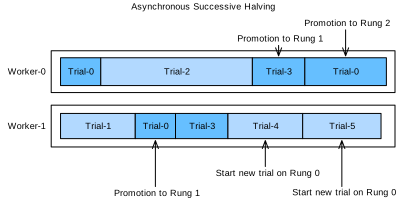
Fig. 19.5.2 Асинхронный последовательный отсев (ASHA) с двумя рабочими.
import logging
from d2l import torch as d2l

logging.basicConfig(level=logging.INFO)
import matplotlib.pyplot as plt
from syne_tune import StoppingCriterion, Tuner
from syne_tune.backend.python_backend import PythonBackend
from syne_tune.config_space import loguniform, randint
from syne_tune.experiments import load_experiment
from syne_tune.optimizer.baselines import ASHA
19.5.1. Целевая функция
Мы будем использовать Syne Tune с той же целевой функцией, что и в Section 19.3.
def hpo_objective_lenet_synetune(learning_rate, batch_size, max_epochs):
    from syne_tune import Reporter
    from d2l import torch as d2l

    model = d2l.LeNet(lr=learning_rate, num_classes=10)
    trainer = d2l.HPOTrainer(max_epochs=1, num_gpus=1)
    data = d2l.FashionMNIST(batch_size=batch_size)
    model.apply_init([next(iter(data.get_dataloader(True)))[0]], d2l.init_cnn)
    report = Reporter()
    for epoch in range(1, max_epochs + 1):
        if epoch == 1:
            # Initialize the state of Trainer
            trainer.fit(model=model, data=data)
        else:
            trainer.fit_epoch()
        validation_error = trainer.validation_error().cpu().detach().numpy()
        report(epoch=epoch, validation_error=float(validation_error))
Мы также будем использовать то же пространство конфигураций, что и ранее:
min_number_of_epochs = 2
max_number_of_epochs = 10
eta = 2

config_space = {
    "learning_rate": loguniform(1e-2, 1),
    "batch_size": randint(32, 256),
    "max_epochs": max_number_of_epochs,
}
initial_config = {
    "learning_rate": 0.1,
    "batch_size": 128,
}
19.5.2. Асинхронный планировщик
Сначала определим количество рабочих процессов, которые будут оценивать эксперименты параллельно. Также необходимо задать продолжительность выполнения случайного поиска, установив верхний предел общего времени работы ⟦wall-clock time⟧.
n_workers = 2  # Needs to be <= the number of available GPUs
max_wallclock_time = 12 * 60  # 12 minutes
Код для запуска ASHA представляет собой простое изменение кода, который мы использовали для асинхронного случайного поиска.
mode = "min"
metric = "validation_error"
resource_attr = "epoch"

scheduler = ASHA(
    config_space,
    metric=metric,
    mode=mode,
    points_to_evaluate=[initial_config],
    max_resource_attr="max_epochs",
    resource_attr=resource_attr,
    grace_period=min_number_of_epochs,
    reduction_factor=eta,
)
Здесь metric и resource_attr задают имена ключей, используемых с
колбэком report, а max_resource_attr указывает, какой вход
целевой функции соответствует \(r_{\mathrm{max}}\). Кроме того,
grace_period предоставляет \(r_{\mathrm{min}}\), а
reduction_factor — это \(\eta\). Мы можем запустить Syne Tune
так же, как и раньше (это займёт около 12 минут):
trial_backend = PythonBackend(
    tune_function=hpo_objective_lenet_synetune,
    config_space=config_space,
)

stop_criterion = StoppingCriterion(max_wallclock_time=max_wallclock_time)
tuner = Tuner(
    trial_backend=trial_backend,
    scheduler=scheduler,
    stop_criterion=stop_criterion,
    n_workers=n_workers,
    print_update_interval=int(max_wallclock_time * 0.6),
)
tuner.run()
Обратите внимание, что мы используем вариант ASHA, в котором
низкоэффективные эксперименты останавливаются досрочно. Это отличается
от нашей реализации в Section 19.4.1, где каждая задача
обучения запускалась с фиксированным числом max_epochs. В последнем
случае хорошо работающий эксперимент, достигающий полных 10 эпох,
сначала должен обучаться 1 эпоху, затем 2, затем 4 и, наконец, 8 эпох,
каждый раз начиная с нуля. Такой тип планирования с приостановкой и
возобновлением можно эффективно реализовать, сохраняя состояние обучения
после каждой эпохи, но здесь мы избегаем этой дополнительной сложности.
После завершения эксперимента мы можем извлечь и визуализировать
результаты.
d2l.set_figsize()
e = load_experiment(tuner.name)
e.plot()
19.5.3. Визуализация процесса оптимизации
Ещё раз визуализируем кривые обучения для каждого испытания (каждый цвет на графике соответствует одному испытанию). Сравните это с асинхронным случайным поиском в Section 19.3. Как мы видели для последовательного отсечения в Section 19.4, большинство испытаний останавливаются на 1 или 2 эпохах (\(r_{\mathrm{min}}\) или \(\eta * r_{\mathrm{min}}\)). Однако испытания не останавливаются в один и тот же момент, поскольку на одну эпоху требуется разное количество времени. Если бы мы использовали стандартное последовательное отсечение вместо ASHA, нам пришлось бы синхронизировать рабочих, прежде чем переводить конфигурации на следующий уровень.
d2l.set_figsize([6, 2.5])
results = e.results
for trial_id in results.trial_id.unique():
    df = results[results["trial_id"] == trial_id]
    d2l.plt.plot(
        df["st_tuner_time"],
        df["validation_error"],
        marker="o"
    )
d2l.plt.xlabel("wall-clock time")
d2l.plt.ylabel("objective function")
19.5.4. Резюме
В отличие от случайного поиска, последовательное отсечение не так просто реализовать в асинхронной распределённой среде. Чтобы избежать точек синхронизации, мы как можно быстрее переводим конфигурации на следующий уровень, даже если это означает продвижение некоторых ошибочных вариантов. На практике это обычно не наносит большого ущерба, а выигрыш от асинхронного планирования по сравнению с синхронным обычно значительно превышает потери от неоптимальных решений.