
9.4. Рекуррентные нейронные сети
В разделе Section 9.3 мы описали марковские модели и n-граммы \(n\) для языкового моделирования, где условная вероятность токена \(x_t\) на шаге времени \(t\) зависит только от \(n-1\) предыдущих токенов. Если мы хотим учесть возможное влияние токенов, предшествующих шагу времени \(t-(n-1)\), на \(x_t\), нам необходимо увеличить \(n\). Однако количество параметров модели также будет расти экспоненциально, поскольку нам потребуется хранить \(|\mathcal{V}|^n\) чисел для словаря \(\mathcal{V}\). Следовательно, вместо моделирования \(P(x_t \mid x_{t-1}, \ldots, x_{t-n+1})\) предпочтительнее использовать модель со скрытыми переменными.
где \(h_{t-1}\) — это скрытое состояние, сохраняющее информацию о последовательности до шага времени \(t-1\). В общем случае скрытое состояние на любом шаге времени \(t\) может быть вычислено на основе как текущего входа \(x_{t}\), так и предыдущего скрытого состояния \(h_{t-1}\):
Для достаточно выразительной функции \(f\) в (9.4.2) модель латентных переменных не является приближением. В конце концов, \(h_t\) может просто хранить все данные, которые она наблюдала до сих пор. Однако это может сделать вычисления и хранение ресурсоемкими.
Напомним, что мы уже обсуждали скрытые слои со скрытыми нейронами в Section 5. Важно отметить, что скрытые слои и скрытые состояния — это два совершенно разных понятия. Скрытые слои, как уже объяснялось, — это слои, которые скрыты от наблюдателя на пути от входа к выходу. Скрытые состояния же технически являются входами для любых операций, выполняемых на данном шаге, и их можно вычислить, только обращаясь к данным предыдущих временных шагов.
Рекуррентные нейронные сети (RNN) — это нейронные сети со скрытыми состояниями. Прежде чем перейти к модели RNN, мы ещё раз рассмотрим модель многослойного перцептрона (MLP), представленную в Section 5.1.
import torch
from d2l import torch as d2l
9.4.1. Нейронные сети без скрытых состояний
Рассмотрим многослойный перцептрон (MLP) с одним скрытым слоем. Пусть функцией активации скрытого слоя будет \(\phi\). Для мини-батча примеров \(\mathbf{X} \in \mathbb{R}^{n \times d}\) размером батча \(n\) и с \(d\) входами выход скрытого слоя \(\mathbf{H} \in \mathbb{R}^{n \times h}\) вычисляется как
В (9.4.3) указаны параметр весов \(\mathbf{W}_{\textrm{xh}} \in \mathbb{R}^{d \times h}\), параметр смещения \(\mathbf{b}_\textrm{h} \in \mathbb{R}^{1 \times h}\) и количество скрытых единиц \(h\) для скрытого слоя. Вооружившись этими данными, мы применяем транслирование (см. Section 2.1.4) при суммировании. Затем выход скрытого слоя \(\mathbf{H}\) используется в качестве входа выходного слоя, который задается формулой
где \(\mathbf{O} \in \mathbb{R}^{n \times q}\) — выходная переменная, \(\mathbf{W}_{\textrm{hq}} \in \mathbb{R}^{h \times q}\) — весовой параметр, а \(\mathbf{b}_\textrm{q} \in \mathbb{R}^{1 \times q}\) — параметр смещения выходного слоя. Если это задача классификации, мы можем использовать \(\mathrm{softmax}(\mathbf{O})\) для вычисления распределения вероятностей выходных категорий.
Это полностью аналогично задаче регрессии, которую мы решали ранее в Section 9.1, поэтому мы опустим детали. Достаточно сказать, что мы можем случайным образом выбирать пары «признак–метка» и обучать параметры нашей сети с помощью автоматического дифференцирования и стохастического градиентного спуска.
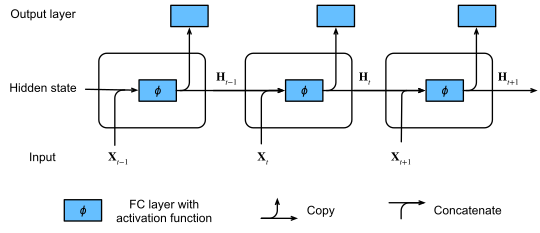
9.4.3. Языковые модели на уровне символов на основе RNN
Вспомним, что в контексте языковой модели в Section 9.3 мы стремимся предсказать следующий токен на основе текущего и предыдущих токенов; поэтому исходная последовательность сдвигается на один токен, чтобы получить целевые значения (метки). Bengio et al. (2003) впервые предложил использовать нейронную сеть для языковой модели. Далее мы покажем, как рекуррентные нейронные сети (RNN) могут быть использованы для построения языковой модели. Пусть размер мини-батча равен единице, а последовательность текста — «machine». Чтобы упростить обучение в последующих разделах, мы будем токенизировать текст по символам, а не по словам, и рассмотрим символьную языковую модель. Fig. 9.4.2 демонстрирует, как предсказывать следующий символ на основе текущего и предыдущих символов с помощью RNN для символьного языкового моделирования.
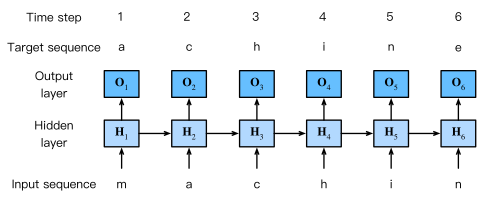
Fig. 9.4.2 Языковая модель на уровне символов, основанная на RNN. Входная и целевая последовательности — «machin» и «achine» соответственно.
В процессе обучения мы применяем операцию софтмакс к выходу выходного слоя на каждом временном шаге, а затем используем перекрёстную энтропию для вычисления ошибки между выходом модели и целевой переменной. В результате рекуррентных вычислений скрытого состояния в скрытом слое выход \(\mathbf{O}_3\) временного шага 3 в Fig. 9.4.2 определяется текстовой последовательностью «m», «a» и «c». Поскольку следующим символом в последовательности обучающих данных является «h», потери на временном шаге 3 будут зависеть от распределения вероятностей следующего символа, сгенерированного на основе последовательности признаков «m», «a», «c», и целевой переменной «h» этого временного шага.
На практике каждый токен представляется \(d\)-мерным вектором, а размер батча равен \(n>1\). Следовательно, вход \(\mathbf X_t\) на шаге времени \(t\) будет представлять собой матрицу размера \(n\times d\), что соответствует обсуждавшемуся в Section 9.4.2.
В следующих разделах мы реализуем RNN для языковых моделей на уровне символов.
9.4.4. Итоги
Нейронная сеть, использующая рекуррентные вычисления для скрытых состояний, называется рекуррентной нейронной сетью (RNN). Скрытое состояние RNN может сохранять историческую информацию о последовательности вплоть до текущего временного шага. Благодаря рекуррентным вычислениям количество параметров модели RNN не растет с увеличением числа временных шагов. Что касается применений, RNN можно использовать для создания языковых моделей на уровне символов.
9.4.5. Упражнения
Если мы используем RNN для предсказания следующего символа в текстовой последовательности, какой должна быть размерность любого вывода?
Почему рекуррентные нейронные сети способны моделировать условную вероятность токена на заданном временном шаге при условии всех предыдущих токенов в текстовой последовательности?
Что происходит с градиентом, если выполнять обратное распространение ошибки по длинной последовательности?
Какие проблемы связаны с языковой моделью, описанной в этом разделе?