
14.13. Классификация изображений (CIFAR-10) на Kaggle
До сих пор мы использовали высокоуровневые API фреймворков глубокого обучения для непосредственного получения наборов данных изображений в формате тензоров. Однако пользовательские наборы данных изображений часто представлены в виде файлов изображений. В этом разделе мы начнем с исходных файлов изображений и шаг за шагом организуем их, прочитаем и преобразуем в формат тензоров.
В разделе Section 14.1 мы экспериментировали с набором данных CIFAR-10, который является важным набором данных в области компьютерного зрения. В этом разделе мы применим знания, полученные в предыдущих разделах, для участия в соревновании Kaggle по классификации изображений CIFAR-10. Ссылка на соревнование: https://www.kaggle.com/c/cifar-10
Fig. 14.13.1 содержит информацию о соревновании на его веб-странице. Для отправки результатов необходимо зарегистрировать аккаунт на Kaggle.
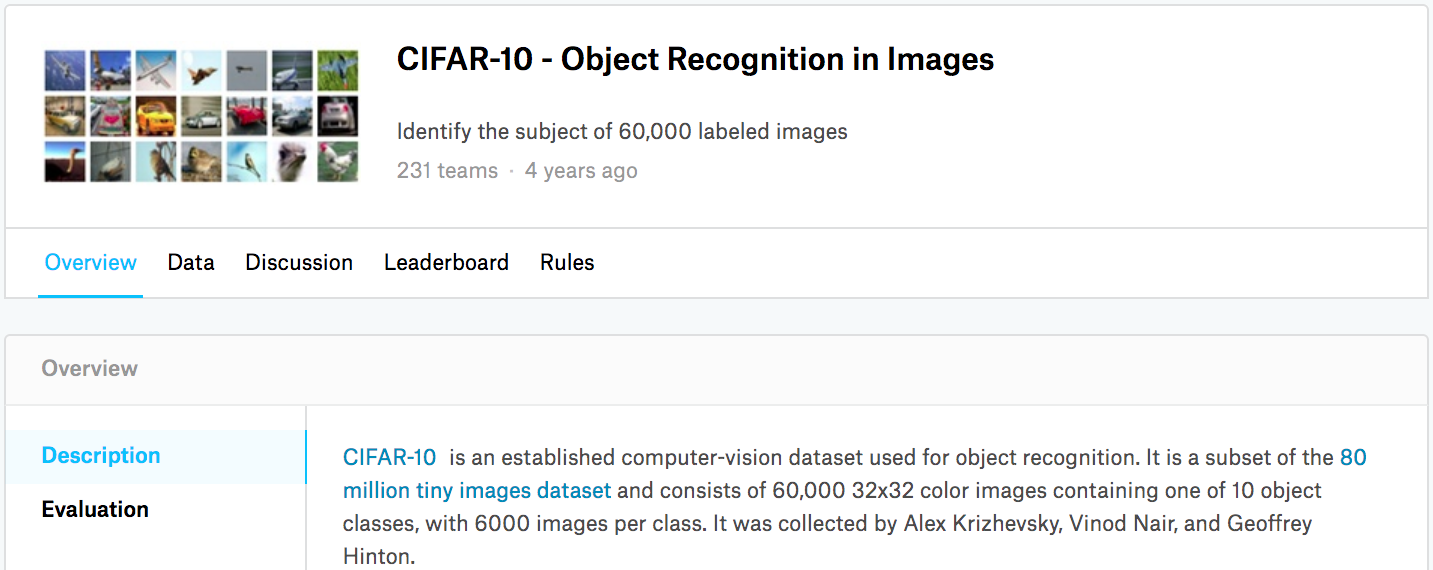
Fig. 14.13.1 Информация о соревновании по классификации изображений CIFAR-10 на веб-странице. Набор данных для соревнования можно получить, перейдя на вкладку «Data».
import collections
import math
import os
import shutil
import pandas as pd
import torch
import torchvision
from torch import nn
from d2l import torch as d2l
14.13.1. Получение и организация набора данных
Набор данных соревнования разделен на обучающую выборку и тестовую выборку, содержащие 50 000 и 300 000 изображений соответственно. В тестовой выборке 10 000 изображений будут использоваться для оценки, тогда как оставшиеся 290 000 изображений оцениваться не будут: они включены лишь для того, чтобы затруднить мошенничество с ручной разметкой тестовой выборки. Все изображения в этом наборе данных являются цветными файлами в формате PNG (каналы RGB), высота и ширина которых составляют 32 пикселя. Изображения охватывают всего 10 категорий, а именно: самолеты, автомобили, птицы, кошки, олени, собаки, лягушки, лошади, лодки и грузовики. В верхнем левом углу Fig. 14.13.1 показаны некоторые изображения самолетов, автомобилей и птиц из набора данных.
14.13.1.1. Скачивание набора данных
После входа в Kaggle мы можем перейти на страницу соревнования по
классификации изображений CIFAR-10, показанного на рисунке
Fig. 14.13.1, и загрузить набор данных, нажав кнопку
«Download All». После распаковки загруженного файла в ../data, а
также распаковки архивов train.7z и test.7z, содержащихся в нём,
мы найдём весь набор данных в следующих путях:
../data/cifar-10/train/[1-50000].png../data/cifar-10/test/[1-300000].png../data/cifar-10/trainLabels.csv../data/cifar-10/sampleSubmission.csv
где каталоги train и test содержат обучающие и тестовые
изображения соответственно, trainLabels.csv содержит метки для
обучающих изображений, а sample_submission.csv — файл примера
отправки.
Чтобы облегчить начало работы, мы предоставляем небольшой набор данных,
содержащий первые 1000 обучающих изображений и 5 случайных тестовых
примеров. Для использования полного набора данных соревнования Kaggle
необходимо установить следующую переменную demo в значение
False.
#@save
d2l.DATA_HUB['cifar10_tiny'] = (d2l.DATA_URL + 'kaggle_cifar10_tiny.zip',
                                '2068874e4b9a9f0fb07ebe0ad2b29754449ccacd')

# If you use the full dataset downloaded for the Kaggle competition, set
# `demo` to False
demo = True

if demo:
    data_dir = d2l.download_extract('cifar10_tiny')
else:
    data_dir = '../data/cifar-10/'
14.13.1.2. Организация набора данных
Для облегчения обучения и тестирования моделей необходимо организовать наборы данных. Сначала прочитаем метки из CSV-файла. Функция ниже возвращает словарь, в котором ключом является часть имени файла до расширения, а значением — соответствующая метка.
#@save
def read_csv_labels(fname):
    """Read `fname` to return a filename to label dictionary."""
    with open(fname, 'r') as f:
        # Skip the file header line (column name)
        lines = f.readlines()[1:]
    tokens = [l.rstrip().split(',') for l in lines]
    return dict(((name, label) for name, label in tokens))

labels = read_csv_labels(os.path.join(data_dir, 'trainLabels.csv'))
print('# training examples:', len(labels))
print('# classes:', len(set(labels.values())))
Далее мы определяем функцию reorg_train_valid для выделения
валидационной выборки из исходной обучающей выборки. Аргумент
valid_ratio этой функции задаёт долю примеров в валидационной
выборке относительно числа примеров в исходной обучающей выборке. Более
конкретно, пусть \(n\) обозначает количество изображений класса с
наименьшим числом примеров, а \(r\) — заданную долю. Тогда
валидационная выборка будет содержать по
\(\max(\lfloor nr\rfloor,1)\) изображений для каждого класса.
Рассмотрим в качестве примера valid_ratio=0.1. Поскольку исходная
обучающая выборка содержит 50000 изображений, в каталоге
train_valid_test/train будет использоваться 45000 изображений для
обучения, а остальные 5000 изображений будут выделены в валидационную
выборку в каталоге train_valid_test/valid. После организации набора
данных изображения одного и того же класса будут помещены в одну папку.
#@save
def copyfile(filename, target_dir):
    """Copy a file into a target directory."""
    os.makedirs(target_dir, exist_ok=True)
    shutil.copy(filename, target_dir)

#@save
def reorg_train_valid(data_dir, labels, valid_ratio):
    """Split the validation set out of the original training set."""
    # The number of examples of the class that has the fewest examples in the
    # training dataset
    n = collections.Counter(labels.values()).most_common()[-1][1]
    # The number of examples per class for the validation set
    n_valid_per_label = max(1, math.floor(n * valid_ratio))
    label_count = {}
    for train_file in os.listdir(os.path.join(data_dir, 'train')):
        label = labels[train_file.split('.')[0]]
        fname = os.path.join(data_dir, 'train', train_file)
        copyfile(fname, os.path.join(data_dir, 'train_valid_test',
                                     'train_valid', label))
        if label not in label_count or label_count[label] < n_valid_per_label:
            copyfile(fname, os.path.join(data_dir, 'train_valid_test',
                                         'valid', label))
            label_count[label] = label_count.get(label, 0) + 1
        else:
            copyfile(fname, os.path.join(data_dir, 'train_valid_test',
                                         'train', label))
    return n_valid_per_label
Функция reorg_test ниже организует тестовую выборку для загрузки
данных при прогнозировании.
#@save
def reorg_test(data_dir):
    """Organize the testing set for data loading during prediction."""
    for test_file in os.listdir(os.path.join(data_dir, 'test')):
        copyfile(os.path.join(data_dir, 'test', test_file),
                 os.path.join(data_dir, 'train_valid_test', 'test',
                              'unknown'))
Наконец, мы используем функцию для вызова read_csv_labels,
reorg_train_valid и reorg_test функций, определённых выше.
def reorg_cifar10_data(data_dir, valid_ratio):
    labels = read_csv_labels(os.path.join(data_dir, 'trainLabels.csv'))
    reorg_train_valid(data_dir, labels, valid_ratio)
    reorg_test(data_dir)
Здесь мы устанавливаем размер батча равным 32 для небольшого набора
данных. При обучении и тестировании полного набора данных соревнования
Kaggle batch_size следует задать в виде большего целого числа,
например 128. Мы выделяем 10% обучающих примеров в качестве
валидационной выборки для настройки гиперпараметров.
batch_size = 32 if demo else 128
valid_ratio = 0.1
reorg_cifar10_data(data_dir, valid_ratio)
14.13.2. Аугментация изображений
Мы используем аугментацию изображений для борьбы с переобучением. Например, во время обучения изображения можно случайно отражать по горизонтали. Мы также можем выполнять стандартизацию для трёх каналов RGB цветных изображений. Ниже приведены некоторые из этих операций, которые вы можете настраивать.
transform_train = torchvision.transforms.Compose([
    # Scale the image up to a square of 40 pixels in both height and width
    torchvision.transforms.Resize(40),
    # Randomly crop a square image of 40 pixels in both height and width to
    # produce a small square of 0.64 to 1 times the area of the original
    # image, and then scale it to a square of 32 pixels in both height and
    # width
    torchvision.transforms.RandomResizedCrop(32, scale=(0.64, 1.0),
                                                   ratio=(1.0, 1.0)),
    torchvision.transforms.RandomHorizontalFlip(),
    torchvision.transforms.ToTensor(),
    # Standardize each channel of the image
    torchvision.transforms.Normalize([0.4914, 0.4822, 0.4465],
                                     [0.2023, 0.1994, 0.2010])])
Во время тестирования мы применяем к изображениям только стандартизацию, чтобы исключить случайность в результатах оценки.
transform_test = torchvision.transforms.Compose([
    torchvision.transforms.ToTensor(),
    torchvision.transforms.Normalize([0.4914, 0.4822, 0.4465],
                                     [0.2023, 0.1994, 0.2010])])
14.13.3. Чтение набора данных
Далее мы загружаем организованный набор данных, состоящий из необработанных файлов изображений. Каждый пример включает изображение и метку.
train_ds, train_valid_ds = [torchvision.datasets.ImageFolder(
    os.path.join(data_dir, 'train_valid_test', folder),
    transform=transform_train) for folder in ['train', 'train_valid']]

valid_ds, test_ds = [torchvision.datasets.ImageFolder(
    os.path.join(data_dir, 'train_valid_test', folder),
    transform=transform_test) for folder in ['valid', 'test']]
Во время обучения нам необходимо задать все описанные выше операции аугментации изображений. При использовании валидационной выборки для оценки модели в процессе подбора гиперпараметров не следует вносить случайность, связанную с аугментацией изображений. Перед финальным прогнозированием мы обучаем модель на объединенной обучающей выборке и валидационной выборке, чтобы максимально использовать все размеченные данные.
train_iter, train_valid_iter = [torch.utils.data.DataLoader(
    dataset, batch_size, shuffle=True, drop_last=True)
    for dataset in (train_ds, train_valid_ds)]

valid_iter = torch.utils.data.DataLoader(valid_ds, batch_size, shuffle=False,
                                         drop_last=True)

test_iter = torch.utils.data.DataLoader(test_ds, batch_size, shuffle=False,
                                        drop_last=False)
14.13.4. Определение модели
Мы определяем модель ResNet-18, описанную в Section 8.6.
def get_net():
    num_classes = 10
    net = d2l.resnet18(num_classes, 3)
    return net

loss = nn.CrossEntropyLoss(reduction="none")
14.13.5. Определение функции обучения
Мы будем выбирать модели и настраивать гиперпараметры, ориентируясь на
качество модели на валидационной выборке. В дальнейшем мы определим
функцию обучения модели train.
def train(net, train_iter, valid_iter, num_epochs, lr, wd, devices, lr_period,
          lr_decay):
    trainer = torch.optim.SGD(net.parameters(), lr=lr, momentum=0.9,
                              weight_decay=wd)
    scheduler = torch.optim.lr_scheduler.StepLR(trainer, lr_period, lr_decay)
    num_batches, timer = len(train_iter), d2l.Timer()
    legend = ['train loss', 'train acc']
    if valid_iter is not None:
        legend.append('valid acc')
    animator = d2l.Animator(xlabel='epoch', xlim=[1, num_epochs],
                            legend=legend)
    net = nn.DataParallel(net, device_ids=devices).to(devices[0])
    for epoch in range(num_epochs):
        net.train()
        metric = d2l.Accumulator(3)
        for i, (features, labels) in enumerate(train_iter):
            timer.start()
            l, acc = d2l.train_batch_ch13(net, features, labels,
                                          loss, trainer, devices)
            metric.add(l, acc, labels.shape[0])
            timer.stop()
            if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
                animator.add(epoch + (i + 1) / num_batches,
                             (metric[0] / metric[2], metric[1] / metric[2],
                              None))
        if valid_iter is not None:
            valid_acc = d2l.evaluate_accuracy_gpu(net, valid_iter)
            animator.add(epoch + 1, (None, None, valid_acc))
        scheduler.step()
    measures = (f'train loss {metric[0] / metric[2]:.3f}, '
                f'train acc {metric[1] / metric[2]:.3f}')
    if valid_iter is not None:
        measures += f', valid acc {valid_acc:.3f}'
    print(measures + f'\n{metric[2] * num_epochs / timer.sum():.1f}'
          f' examples/sec on {str(devices)}')
14.13.6. Обучение и проверка модели
Теперь мы можем обучить и проверить модель. Все указанные гиперпараметры
можно настроить. Например, можно увеличить количество эпох. Если
значения lr_period и lr_decay равны 4 и 0,9 соответственно,
скорость обучения алгоритма оптимизации будет умножаться на 0,9 после
каждых 4 эпох. Для удобства демонстрации мы здесь обучаем модель всего
20 эпох.
devices, num_epochs, lr, wd = d2l.try_all_gpus(), 20, 2e-4, 5e-4
lr_period, lr_decay, net = 4, 0.9, get_net()
net(next(iter(train_iter))[0])
train(net, train_iter, valid_iter, num_epochs, lr, wd, devices, lr_period,
      lr_decay)
14.13.7. Классификация тестовой выборки и отправка результатов на Kaggle
Получив перспективную модель с подобранными гиперпараметрами, мы используем все размеченные данные (включая валидационную выборку) для повторного обучения модели и классификации тестовой выборки.
net, preds = get_net(), []
net(next(iter(train_valid_iter))[0])
train(net, train_valid_iter, None, num_epochs, lr, wd, devices, lr_period,
      lr_decay)

for X, _ in test_iter:
    y_hat = net(X.to(devices[0]))
    preds.extend(y_hat.argmax(dim=1).type(torch.int32).cpu().numpy())
sorted_ids = list(range(1, len(test_ds) + 1))
sorted_ids.sort(key=lambda x: str(x))
df = pd.DataFrame({'id': sorted_ids, 'label': preds})
df['label'] = df['label'].apply(lambda x: train_valid_ds.classes[x])
df.to_csv('submission.csv', index=False)
Приведённый выше код создаст файл submission.csv, формат которого
соответствует требованиям соревнования Kaggle. Метод отправки
результатов на Kaggle аналогичен описанному в
Section 5.7.
14.13.8. Резюме
Мы можем читать наборы данных, содержащие необработанные изображения, после того как они будут организованы в требуемом формате.
Мы можем использовать свёрточные нейронные сети и аугментацию изображений на соревнованиях по классификации изображений.
14.13.9. Упражнения
Для участия в соревновании на Kaggle используйте полный набор данных CIFAR-10. Задайте гиперпараметры как
batch_size = 128,num_epochs = 100,lr = 0.1,lr_period = 50иlr_decay = 0.1. Посмотрите, какие точность и место в рейтинге вы сможете достичь в этом соревновании. Можете ли вы улучшить эти показатели?Какую точность можно получить, не используя аугментацию изображений?